Was ein Data-Science-Exposé auf Masterniveau leisten muss
Ein Exposé ist ein Machbarkeitsnachweis: Du zeigst, dass deine Fragestellung mit den dir verfügbaren Daten und Methoden innerhalb der Bearbeitungszeit tatsächlich beantwortbar ist. Auf Masterniveau reicht dafür nicht mehr die bloße Nennung eines Themas — Betreuende erwarten ein erkennbares Forschungsdesign: welche Modellklasse du einsetzen willst, wie du dein Modell validierst, und warum genau diese Wahl zur Fragestellung passt. Ein Exposé, das erst „ein Modell trainieren“ verspricht und Details offenlässt, wird an den meisten Data-Science-Lehrstühlen zur Überarbeitung zurückgegeben. Diese Erwartungshaltung unterscheidet sich spürbar von der ersten Studienphase, in der ein grob umrissenes Vorhaben oft noch genügte.
Was ein Data-Science-Exposé von anderen Fächern unterscheidet
In vielen Fächern ist die Datenerhebung ein nachgelagerter Schritt nach der Themenfindung. In der Data Science ist sie oft der limitierende Faktor von Anfang an: Ohne einen konkreten, zugänglichen und ausreichend großen Datensatz lässt sich die Fragestellung schlicht nicht bearbeiten, unabhängig davon, wie interessant sie theoretisch ist. Das bedeutet: Die Reihenfolge dreht sich in der Praxis oft um — viele erfolgreiche Data-Science-Exposés beginnen nicht mit der Fragestellung, sondern mit der Entdeckung eines vielversprechenden Datensatzes, aus dem sich anschließend eine passende Forschungsfrage entwickeln lässt.
Die sechs Bausteine eines Data-Science-Exposés
1. Thema und Relevanz
Formuliere das Thema so eng, dass Fragestellung und Modellklasse bereits erkennbar sind, und begründe in zwei bis drei Sätzen die praktische oder wissenschaftliche Relevanz — etwa eine Lücke in bisherigen Prognoseansätzen oder ein neu verfügbarer Datensatz, der eine bislang unbeantwortbare Frage jetzt zugänglich macht.
2. Problemstellung
Beschreibe, was bereits bekannt ist und wo die Forschungslücke liegt — idealerweise mit Bezug auf mindestens eine konkrete Vorstudie, deren Limitation deine Arbeit adressiert.
3. Forschungsfrage und Zielsetzung
Eine gute Data-Science-Forschungsfrage benennt Zielgröße, Prädiktoren (oder zumindest die Datenbasis) und das Bewertungskriterium für Erfolg — etwa „Wie genau lässt sich mit öffentlich verfügbaren Wetterdaten die Energieerzeugung einer Photovoltaikanlage 24 Stunden im Voraus vorhersagen, gemessen am mittleren absoluten Fehler gegenüber einem naiven Referenzmodell?“.
4. Forschungsdesign: Modellklasse und Validierungsstrategie
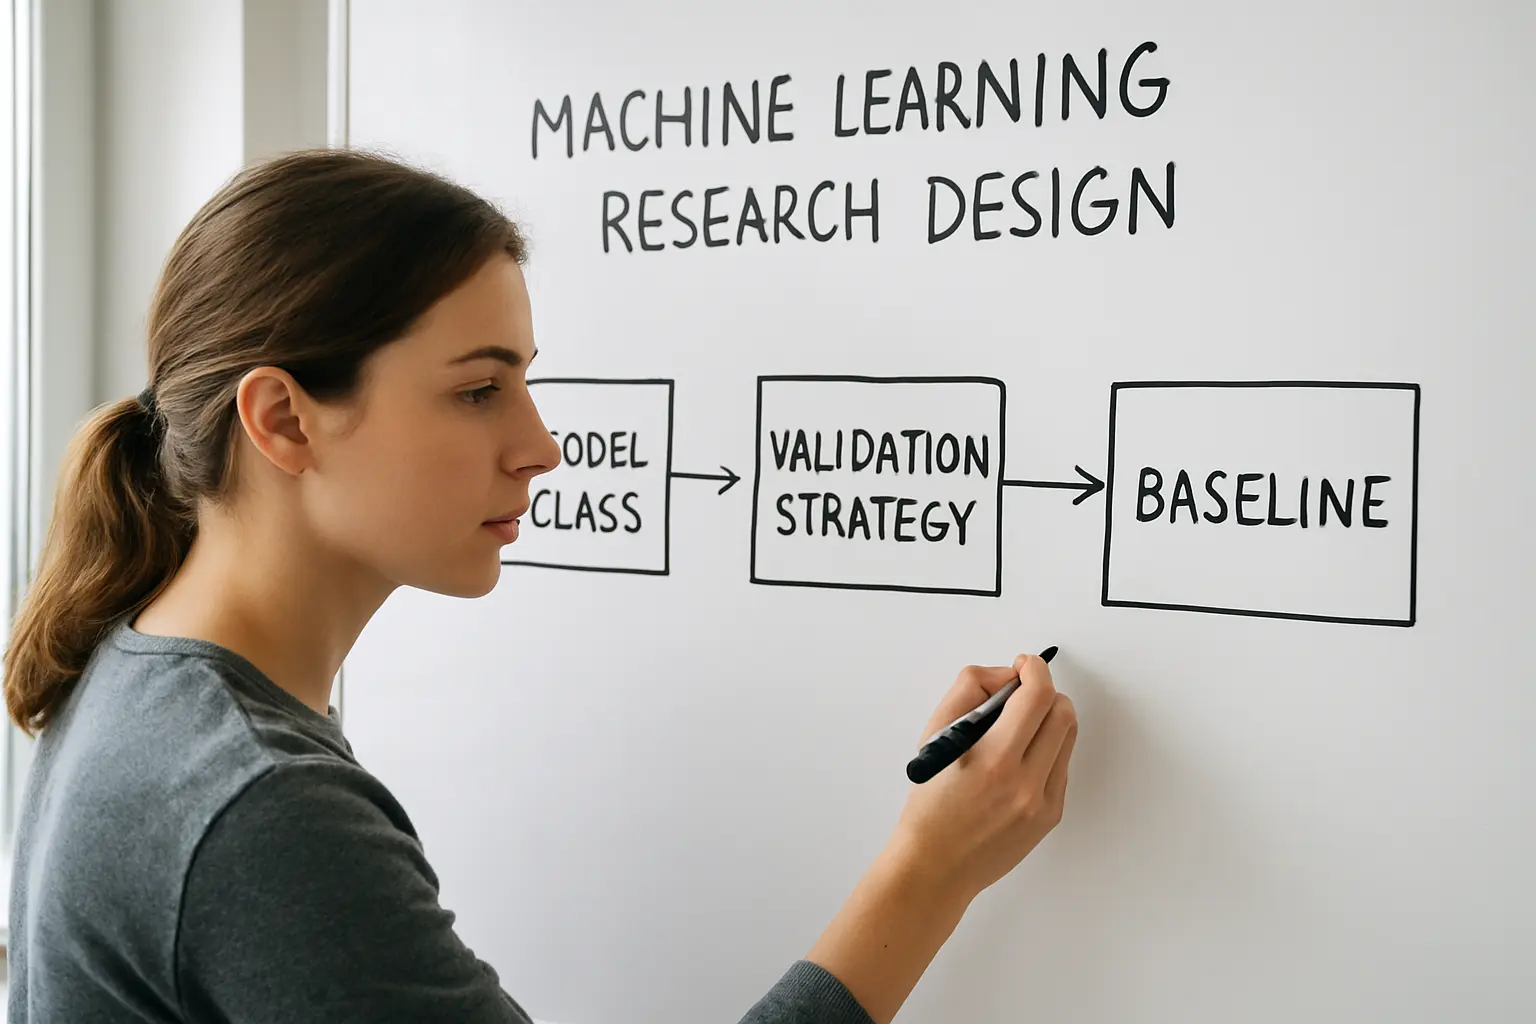
Benenne mindestens eine Modellklasse (z. B. Gradient-Boosting-Verfahren statt eines rein linearen Modells) und begründe kurz, warum sie zur Datenstruktur passt. Lege außerdem fest, wie du dein Modell validierst — ein einfacher Train-Test-Split, eine zeitliche Validierung bei Zeitreihendaten, oder eine Kreuzvalidierung — und warum genau dieses Verfahren zur Datenlage passt.
5. Datenzugang
Nenne die konkrete Datenquelle mit Link oder DOI, nicht nur „ein offener Datensatz“. Ein Satz zur Lizenz und, falls bereits geprüft, zur ungefähren Datensatzgröße signalisiert, dass du die Verfügbarkeit bereits verifiziert hast.
6. Zeitplan mit Meilensteinen
Ein realistischer Zeitplan mit klar getrennten Phasen für Datenexploration, Modellentwicklung, Evaluation und Schreibphase, inklusive Pufferzeit für unerwartete Datenqualitätsprobleme.
Forschungsdesign: Wie du Modellklasse und Validierungsstrategie im Exposé begründest
Vermeide die häufige Formulierung „ich werde verschiedene Modelle testen und das beste auswählen“ ohne weitere Eingrenzung — das wirkt auf Betreuende wie eine fehlende methodische Vorentscheidung. Begründe stattdessen, warum eine bestimmte Modellklasse zur Struktur deiner Daten passt: Gradient-Boosting-Verfahren eignen sich gut für strukturierte, tabellarische Daten mit nichtlinearen Zusammenhängen, rekurrente oder Transformer-Architekturen für sequenzielle Zeitreihen- oder Textdaten, klassische lineare oder logistische Modelle als nachvollziehbare Baseline, gegen die komplexere Modelle sich rechtfertigen müssen. Ein Exposé, das explizit eine Baseline benennt, gegen die spätere Modelle verglichen werden, signalisiert methodische Reife.
Datenzugang: Warum das der kritischste Baustein ist
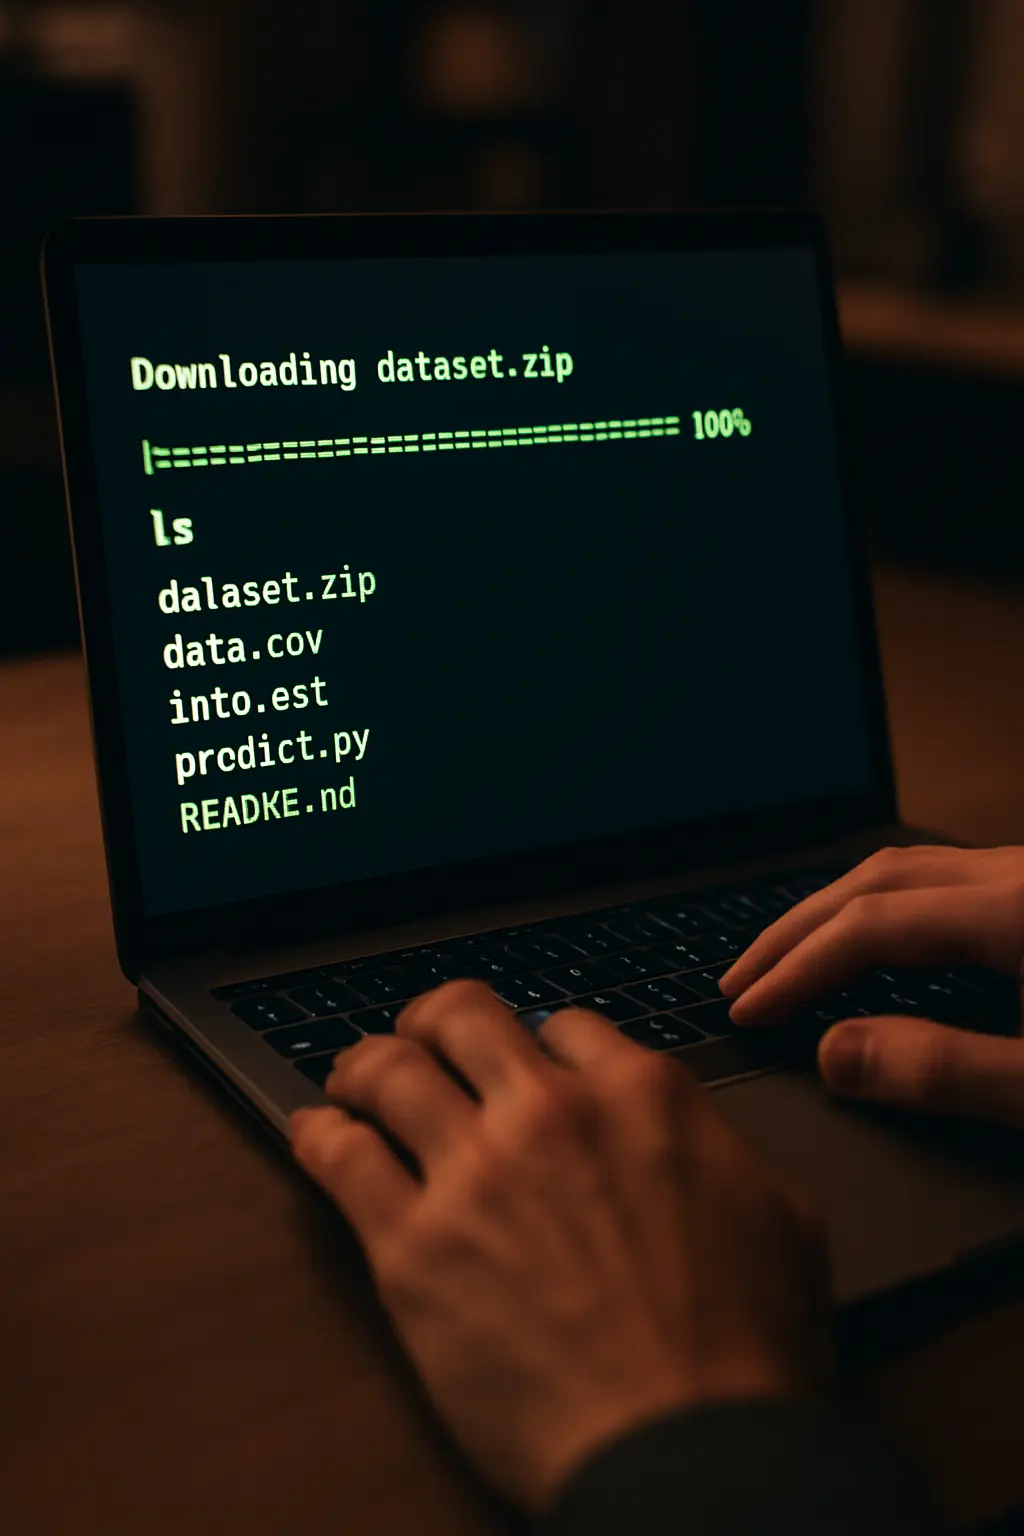
Ein ungeklärter Datenzugang ist einer der häufigsten Gründe, warum Betreuende ein Data-Science-Exposé zurückgeben. Der Grund: Eine Fragestellung lässt sich meist noch anpassen, ein fehlender Datenzugang macht die gesamte Arbeit unmöglich, egal wie gut die Theorie ist. Kläre deshalb vor der Exposé-Abgabe nicht nur, DASS ein Datensatz existiert, sondern lade ihn testweise herunter, prüfe Format, Größe und offensichtliche Datenqualitätsprobleme, und dokumentiere das kurz im Exposé. Diese Vorabprüfung nimmt dir zwar Zeit vor der eigentlichen Bearbeitungszeit, erspart dir aber eine böse Überraschung in Woche drei der Bearbeitungszeit, wenn sich der Datensatz als unbrauchbar herausstellt.
Ethikvotum und Datenschutz bei sensiblen Datensätzen
Nicht jede Data-Science-Masterarbeit braucht ein formales Ethikvotum, aber sobald dein Datensatz personenbezogene oder besonders sensible Daten enthält (Gesundheits-, Standort- oder Verhaltensdaten einzelner Personen), solltest du das bereits im Exposé thematisieren. Prüfe, ob der Datensatz als vollständig anonymisiert dokumentiert ist — dann entfällt meist ein formales Votum — oder ob er nur pseudonymisiert vorliegt, was ihn weiterhin als personenbezogenes Datum im Sinne der DSGVO behandelbar macht. Bei Unsicherheit lohnt sich eine kurze Rückfrage bei deinem Betreuer schon vor der Exposé-Abgabe, statt diese Frage erst während der eigentlichen Bearbeitungszeit zu klären, wenn eine nachträgliche Kurskorrektur deutlich teurer in Zeit wird.
Zeitplan für eine Data-Science-Masterarbeit: Typische Meilensteine
Ein realistischer Zeitplan für eine sechsmonatige Masterarbeit gliedert sich grob in: zwei bis drei Wochen Datenexploration und -bereinigung (oft unterschätzt — Datenbereinigung nimmt in der Praxis häufig mehr Zeit in Anspruch als die Modellentwicklung selbst); vier bis sechs Wochen Modellentwicklung und erste Evaluation; zwei bis drei Wochen vertiefte Evaluation und Fehleranalyse; und die restliche Zeit für Schreibphase und Überarbeitung. Plane explizit eine Pufferwoche zwischen Modellentwicklung und Schreibphase ein — Datenqualitätsprobleme, die erst bei der detaillierten Fehleranalyse auffallen, sind in der Data-Science-Praxis eher die Regel als die Ausnahme. Ergänze den Zeitplan um konkrete Zwischenmeilensteine mit deinem Betreuer (z. B. ein erstes lauffähiges Baseline-Modell nach sechs Wochen), damit Abweichungen vom Plan frühzeitig sichtbar werden, statt erst kurz vor Abgabe.
Ein kurzer, fiktiver Beispielauszug aus einem Exposé
Forschungsfrage: Wie genau lässt sich mit öffentlich verfügbaren Wetterdaten die Energieerzeugung einer Photovoltaikanlage 24 Stunden im Voraus vorhersagen?
Modellklasse: Gradient-Boosting-Regression (LightGBM), mit einer linearen Regression als Baseline.
Validierung: Zeitlich getrennter Train-Test-Split (kein zufälliger Split, da Zeitreihendaten), ergänzt um eine rollierende Kreuzvalidierung über mehrere Jahreszeiträume.
Datenzugang: NASA Earthdata für Strahlungsdaten (getestet, Zugriff funktioniert, Format NetCDF), kombiniert mit einem bereits identifizierten Kaggle-Datensatz zu historischen Solarertragsdaten (CC-BY-Lizenz, 3 Jahre stündliche Daten).
Warum dieses Design: Die Kombination zweier komplementärer, bereits verifizierter Quellen sichert ausreichend Datenumfang, und die zeitlich getrennte Validierung vermeidet eine unrealistische Überschätzung der Modellgüte durch zufällige Datenlecks zwischen Trainings- und Testzeiträumen.
Bachelor- oder Master-Niveau: Wo liegt der Unterschied im Exposé?
Ein Bachelor-Exposé kommt oft mit der Nennung eines geeigneten offenen Datensatzes und einer plausiblen Modellklasse aus. Ein Master-Exposé verlangt zusätzlich eine explizite Validierungsstrategie, eine benannte Baseline zum Vergleich, und häufig bereits eine kurze Einschätzung möglicher Limitationen des gewählten Datensatzes (z. B. zeitlicher Abdeckungszeitraum, bekannte Verzerrungen) — Aspekte, die auf Bachelorniveau seltener bereits im Exposé erwartet werden.
Checkliste vor der Abgabe deines Data-Science-Exposés
- Ist die Forschungsfrage mit Zielgröße, Datenbasis und Bewertungskriterium konkret genug formuliert?
- Ist mindestens eine Modellklasse benannt und gegen die Datenstruktur begründet?
- Ist eine Validierungsstrategie festgelegt, die zur Datenstruktur (z. B. Zeitreihe) passt?
- Ist der Datensatz konkret benannt, mit Link oder DOI, und idealerweise bereits testweise heruntergeladen?
- Enthält der Zeitplan eine Pufferphase für Datenqualitätsprobleme?
Häufige Fehler im Data-Science-Exposé
- Vager Datenzugang: „Ich finde sicher einen passenden Datensatz auf Kaggle“ statt einer konkret geprüften Quelle.
- Fehlende Modellklasse: „Ich werde Machine Learning einsetzen“ ohne jede Eingrenzung der Methode.
- Keine Baseline: Ein komplexes Modell wird geplant, ohne einen einfachen Vergleichsmaßstab zu benennen.
- Falsche Validierungsstrategie: Ein zufälliger Train-Test-Split wird bei Zeitreihendaten geplant, was zu unrealistisch optimistischen Ergebnissen führt.
- Zeitplan ohne Puffer: Datenbereinigung und unerwartete Qualitätsprobleme werden im Zeitplan nicht berücksichtigt.
FAQ zum Exposé für die Data-Science-Masterarbeit
Muss ich im Exposé bereits ein konkretes Modell benennen?
Nicht zwingend ein einzelnes finales Modell, aber zumindest eine Modellklasse (z. B. Gradient Boosting statt neuronale Netze) mit kurzer Begründung wird auf Masterniveau meist erwartet.
Wie genau muss der Datenzugang im Exposé geklärt sein?
Im Idealfall ist der konkrete Datensatz bereits identifiziert und ein erster Testzugriff erfolgt; zumindest sollte eine realistische, konkret benannte Quelle mit Link oder DOI im Exposé stehen, keine vage Absichtserklärung.
Wie lang sollte ein Data-Science-Exposé sein?
Drei bis fünf Seiten sind für eine Masterarbeit üblich, etwas länger als bei vielen anderen Fächern, weil Forschungsdesign und Datenzugang detaillierter begründet werden müssen.
Was, wenn sich mein Datensatz nach der Exposé-Abgabe als unbrauchbar herausstellt?
Kläre so früh wie möglich mit deinem Betreuer eine Alternative — halte dir deshalb schon im Exposé eine zweite, ebenfalls geprüfte Datenquelle als Rückfalloption im Hinterkopf, auch wenn sie dort nicht ausführlich beschrieben wird.
Brauche ich für mein Exposé bereits Programmierkenntnisse in der finalen Modellierungssprache?
Grundkenntnisse solltest du mitbringen, um die Machbarkeit realistisch einschätzen zu können; die vertiefte Umsetzung findet aber erst während der eigentlichen Bearbeitungszeit statt.
Wie gehe ich mit einem Datensatz um, der noch aktualisiert wird, während ich arbeite?
Sichere dir zu Beginn der Bearbeitungszeit eine feste, lokal gespeicherte Version des Datensatzes und dokumentiere das Zugriffsdatum im Exposé beziehungsweise später im Methodikteil — so bleibt dein Ergebnis auch dann reproduzierbar, wenn sich die Originalquelle später ändert.
Sollte ich im Exposé bereits Hyperparameter oder technische Details nennen?
Nein, das wäre auf Exposé-Ebene zu detailliert — die Modellklasse und die grobe Validierungsstrategie reichen; konkrete Hyperparameter gehören in den Methodikteil der fertigen Arbeit.
Wie unterscheidet sich ein Data-Science-Exposé von einem klassischen empirischen Exposé in der BWL oder Psychologie?
Der grundlegende Aufbau (Thema, Problemstellung, Forschungsfrage, Methodik, Zeitplan) ist ähnlich, aber die Methodik wird bei Data Science um eine explizite Modellklassen- und Validierungsdiskussion erweitert, während die Stichprobenplanung durch die Datenzugangsprüfung ersetzt wird.
Muss ich im Exposé bereits erwähnen, ob ich Cloud-Rechenressourcen benötige?
Wenn dein geplantes Modell (z. B. große neuronale Netze) absehbar mehr Rechenleistung braucht, als ein normaler Laptop bietet, ist ein kurzer Hinweis im Exposé sinnvoll — das signalisiert, dass du die technische Machbarkeit bereits mitgedacht hast, und gibt deinem Betreuer die Chance, frühzeitig auf verfügbare Hochschul-Rechencluster oder Fördermöglichkeiten hinzuweisen.
Wie gehe ich mit einem Datensatz um, der zwar öffentlich, aber sehr groß ist?
Erwähne im Exposé kurz, wie du mit dem Speicher- und Rechenaufwand umgehen willst — etwa durch eine repräsentative Teilstichprobe für die Exploration und volle Nutzung erst für das finale Modelltraining. Das zeigt, dass du praktische Machbarkeit von Anfang an mitdenkst, statt sie erst während der Bearbeitung zu entdecken.
Wie unterscheidet sich das Exposé vom späteren Methodenkapitel der fertigen Arbeit?
Das Exposé beschreibt ein Vorhaben und wird selbst nicht Teil der fertigen Arbeit; das Methodenkapitel greift dieselben Bausteine inhaltlich wieder auf, ist dann aber ausführlicher, bereits mit tatsächlich verwendeten Parametern belegt, und beschreibt das reale statt das geplante Vorgehen.
Muss ich im Exposé bereits festlegen, in welcher Programmiersprache ich arbeiten werde?
Eine grobe Angabe (z. B. Python oder R) ist sinnvoll, weil sie zeigt, dass du die technische Machbarkeit bereits mitgedacht hast, eine verbindliche Festlegung wird auf Exposé-Ebene aber meist nicht erwartet. Wichtiger als die konkrete Sprache ist, dass die im Exposé benannte Modellklasse in der gewählten Sprache mit den vorhandenen Bibliotheken realistisch umsetzbar ist — bei sehr ausgefallenen Modellklassen lohnt sich ein kurzer Vorab-Check, ob eine stabile, gut dokumentierte Implementierung überhaupt existiert. Ein späterer Wechsel der Programmiersprache während der Bearbeitungszeit ist unüblich, aber nicht grundsätzlich ausgeschlossen, wenn sich die ursprüngliche Wahl als ungeeignet erweist und du das mit deinem Betreuer abstimmst.
Zur allgemeinen Exposé-Struktur am Beispiel eines anderen Fachs: Wie schreibst du ein Exposé für die Pflegewissenschaft-Bachelorarbeit?. Zu Datenquellen für die Data-Science-Abschlussarbeit im Detail: Wo finden Data-Science-Studierende Datensätze für die Abschlussarbeit? 12 Quellen. Zur Themenfindung davor: Themen für die Data-Science-Abschlussarbeit: 30 Vorschläge mit Forschungsfrage und Datenzugang. Und zum Methodenkapitel danach: Methodenkapitel Data-Science-Abschlussarbeit: CRISP-DM, Datensplit und Reproduzierbarkeit.