„Ich will etwas mit KI und Cybersecurity machen“ ist ein Satz, mit dem viele Informatik-Studierende ihre Themensuche beginnen — und an dem sie leicht hängen bleiben, weil das Feld für eine Bachelorarbeit viel zu breit ist. Dieser Beitrag zeigt, wie du aus dem Trendthema KI-gestützte Bedrohungserkennung ein konkretes, in einer Bachelorarbeit bearbeitbares Thema entwickelst — mit Problemstellung, Datensätzen und einem durchdachten Beispiel.
Warum „KI in der Cybersecurity“ als Thema zu breit ist
Cybersecurity selbst umfasst Netzwerksicherheit, Anwendungssicherheit, Kryptografie, Social Engineering und mehr — KI wird darin für völlig unterschiedliche Aufgaben eingesetzt: Anomalieerkennung im Netzwerkverkehr, Phishing-Erkennung in E-Mails, Malware-Klassifikation oder die Absicherung von KI-Systemen selbst gegen Angriffe. Ein Thema wie „KI zur Verbesserung der Cybersecurity“ lässt sich in einer Bachelorarbeit nicht seriös bearbeiten — zu viele mögliche Angriffsarten, Datentypen und Modellansätze stehen zur Wahl. Der erste Schritt ist deshalb nicht die Methode, sondern die Eingrenzung auf ein konkretes Teilthema.
Vier konkrete, eingrenzbare Teilthemen
- Netzwerk-Anomalieerkennung: Maschinelles Lernen zur Identifikation ungewöhnlichen Datenverkehrs als Hinweis auf einen Angriff (Intrusion Detection). Gut geeignet, wenn du dich für klassische ML-Verfahren und strukturierte, tabellarische Daten interessierst.
- Phishing-Erkennung mit NLP: Textklassifikation von E-Mails oder URLs zur automatisierten Erkennung von Phishing-Versuchen. Geeignet, wenn dein Interesse eher bei Sprachverarbeitung liegt.
- Malware-Klassifikation: Überwachtes Lernen zur Einordnung von Dateien oder Verhaltensmustern als schädlich oder harmlos. Erfordert meist etwas mehr Vorwissen zu Dateiformaten oder Systemverhalten.
- Adversarial Robustness: Untersuchung, wie robust ein KI-gestütztes Erkennungssystem selbst gegenüber gezielten Angriffen auf das Modell ist. Anspruchsvoller, aber besonders interessant, weil ML-basierte Erkennungssysteme selbst zum Angriffsziel werden können.
Jedes dieser vier Teilthemen ist eigenständig groß genug für eine Bachelorarbeit — kombiniere sie nicht, sondern wähle eines und grenze es dann noch weiter ein, etwa auf einen bestimmten Angriffstyp oder eine bestimmte Modellklasse.
Wie du dein Thema mit deiner Betreuung abstimmst
Bevor du dich auf eines der vier Teilthemen festlegst, kläre mit deiner Betreuung, welche Vorkenntnisse und welcher Rechenzugang (eigener Rechner, Uni-Cluster, Cloud-Ressourcen) für dein Vorhaben realistisch sind. Adversarial Robustness etwa verlangt oft mehr Rechenleistung und tieferes ML-Verständnis als eine klassische Anomalieerkennung mit einem Random-Forest-Modell. Bringe zum ersten Gespräch bereits eine grobe Vorauswahl von zwei Teilthemen mit ein bis zwei möglichen Datensätzen mit — das beschleunigt die Themenfindung gegenüber einem offenen „Was schlagen Sie vor?“.
Beispiel-Ausarbeitung: Netzwerk-Anomalieerkennung durchdacht (illustrativ)
Das folgende Beispiel ist als Orientierung gedacht und ersetzt nicht deine eigene, mit der Betreuung abgestimmte Themenformulierung.
| Baustein | Beispielhafte Ausarbeitung |
|---|---|
| Problemstellung | Signaturbasierte Intrusion-Detection-Systeme erkennen vor allem bereits bekannte Angriffsmuster; neuartige Angriffe können unentdeckt bleiben. |
| Forschungsfrage | Wie gut erkennt ein überwachtes Klassifikationsmodell Angriffe im Netzwerkverkehr im Vergleich zu einer regel- bzw. signaturbasierten Baseline? |
| Variablen | Merkmale des Netzwerkverkehrs (Paketgröße, Protokoll, Verbindungsdauer) als Eingaben; Klassifikation normal/anomal als Zielgröße |
| Methodisches Vorgehen | Training eines Klassifikationsmodells (z. B. Random Forest oder ein einfaches neuronales Netz) auf einem öffentlichen Datensatz, Vergleich mit einer einfachen Baseline |
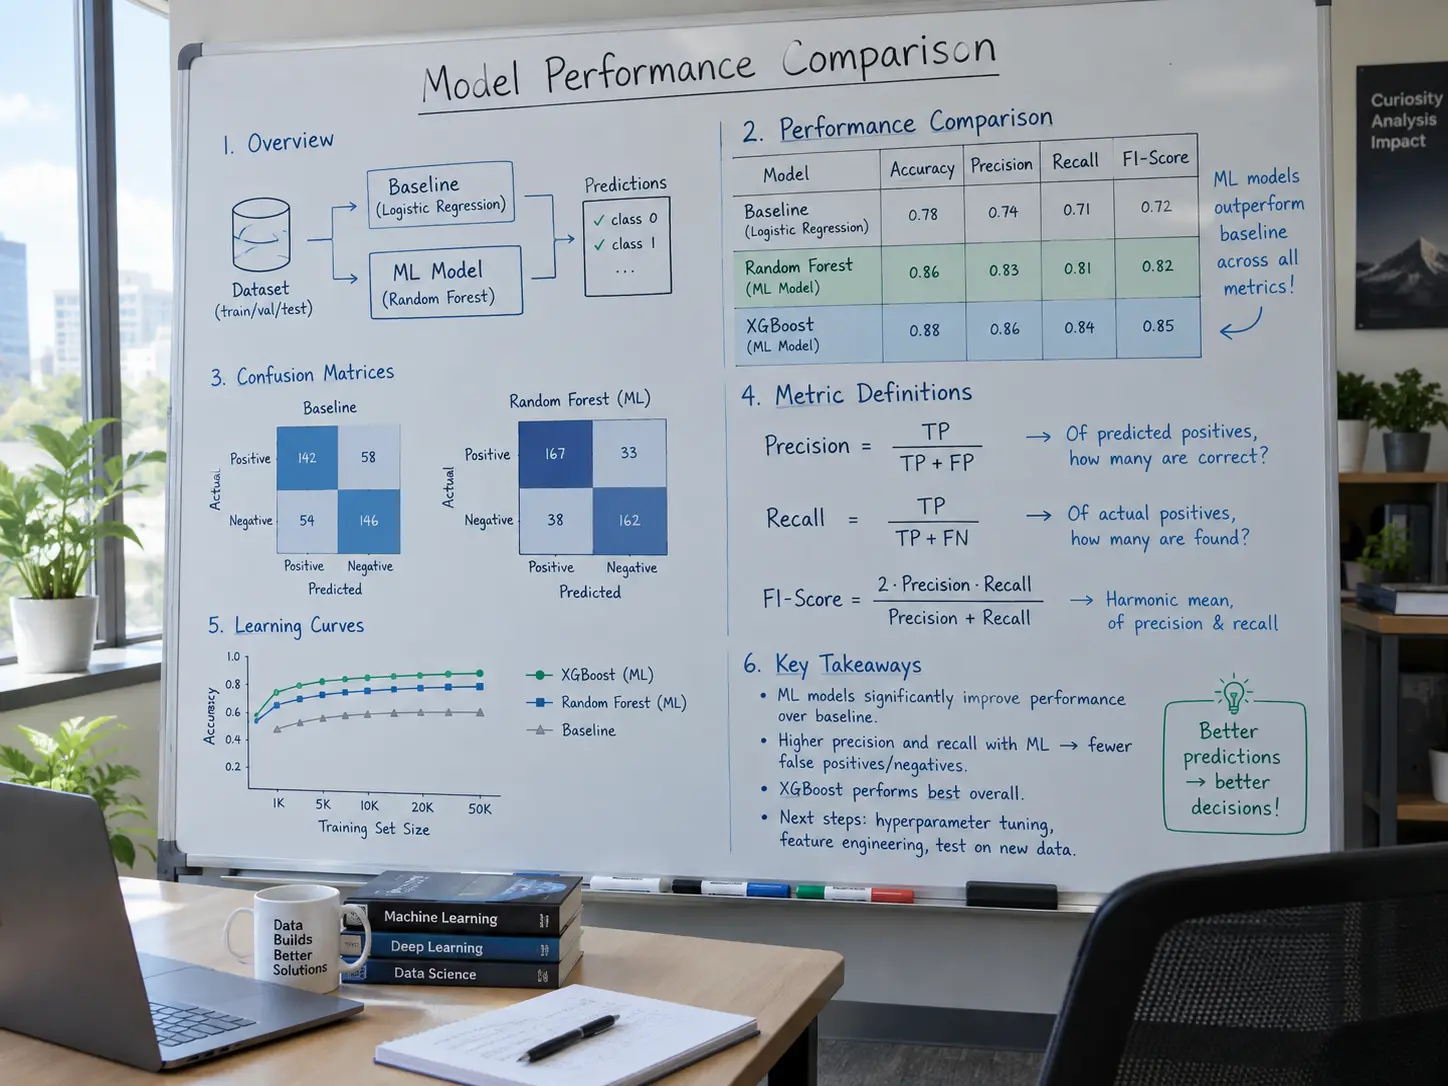
| Evaluationsmetriken | Precision, Recall, F1-Score, ROC-AUC — nicht nur Accuracy, da Angriffsdaten in solchen Datensätzen oft unterrepräsentiert sind |
Wo bekommst du Trainingsdaten her?
Für Bachelorarbeiten zur Netzwerk-Anomalieerkennung sind öffentlich verfügbare Benchmark-Datensätze der übliche Weg — eigene Netzwerkdaten aus einem Unternehmen zu bekommen, ist im Zeitrahmen einer Bachelorarbeit meist unrealistisch und wirft zusätzliche Datenschutzfragen auf:
- CICIDS2017: Vom Canadian Institute for Cybersecurity (University of New Brunswick) bereitgestellter Datensatz mit gutartigem Verkehr und gängigen Angriffen als PCAPs sowie daraus abgeleiteten Flow-Merkmalen.
- NSL-KDD: Eine überarbeitete Version des älteren KDD-Cup-99-Datensatzes, die einige von dessen bekannten Problemen beheben sollte. Das CIC weist selbst darauf hin, dass auch NSL-KDD reale Netze nicht perfekt abbildet — und führt den Datensatz auf seiner Seite inzwischen als nicht mehr verfügbar. Beziehst du ihn aus einer anderen Quelle, dokumentiere Herkunft und Version genau.
- UNSW-NB15: Im Cyber Range Lab der UNSW Canberra erzeugter Datensatz, der reale normale Aktivitäten mit synthetischen, zeitgemäßen Angriffen kombiniert.
Für Phishing-Erkennung bieten sich gemeldete Phishing-URLs aus Quellen wie PhishTank in Kombination mit legitimen URL-Listen an. Prüfe bei jedem Datensatz die Lizenz- bzw. Nutzungsbedingungen und zitiere die Originalveröffentlichung, aus der der Datensatz stammt — nicht nur die Download-Seite.
Vorverarbeitung: die Schritte, die im Methodikkapitel stehen sollten
Zwischen Download und Modelltraining liegt bei Netzwerkdaten meist mehr Arbeit, als man erwartet. Beschreibe diese Schritte in deinem Methodikkapitel ausdrücklich, denn sie beeinflussen deine Ergebnisse oft stärker als die Wahl des Modells:
- Bereinigung: Umgang mit fehlenden oder unendlichen Werten, doppelten Einträgen und offensichtlich fehlerhaften Zeilen dokumentieren.
- Kodierung: Kategoriale Merkmale wie das Protokoll in numerische Form bringen (z. B. One-Hot-Encoding) und die Entscheidung begründen.
- Skalierung: Merkmale mit sehr unterschiedlichen Wertebereichen normalisieren — und zwar nur auf Basis der Trainingsdaten.
- Merkmalsauswahl: Begründen, welche Merkmale du verwendest und welche du bewusst ausschließt, etwa Kennungen, die das Modell „auswendig lernen“ könnte.
- Aufteilung: Trainings-, Validierungs- und Testdaten festlegen und angeben, ob zufällig oder zeitlich getrennt wurde.
Verwandte Themenfelder, die sich ebenfalls eingrenzen lassen
Neben den vier vorgestellten Kernthemen gibt es angrenzende Varianten: die Erkennung von Bot-Netzwerken im Netzwerkverkehr, die automatisierte Priorisierung von Sicherheitswarnungen in einem Security Operations Center oder die Analyse, wie erklärbar (Explainable AI) ein bestehendes Erkennungsmodell für menschliche Analystinnen und Analysten tatsächlich ist. Letzteres verbindet technische Umsetzung mit einer nutzerorientierten Fragestellung. Auch eine vergleichende Arbeit — mehrere Modellklassen auf demselben Datensatz gegenüberzustellen — ist eine solide, gut eingrenzbare Alternative, wenn dir die Auswahl unter den vier Kernthemen schwerfällt.
Reproduzierbarkeit: ein oft unterschätztes Bewertungskriterium
Dokumentiere die genaue Datensatzversion, alle Vorverarbeitungsschritte, die verwendeten Hyperparameter und die Zufalls-Seeds deiner Experimente. Ein Ergebnis, das sich mit denselben Angaben nicht nachvollziehen lässt, ist schwer zu bewerten — unabhängig davon, wie gut die reine Modellperformance aussieht. Ein kurzer Abschnitt „Reproduzierbarkeit“ im Methodikkapitel, der diese Angaben bündelt, macht deine Arbeit für Gutachtende deutlich leichter prüfbar. Achte bei der Aufteilung in Trainings- und Testdaten außerdem darauf, dass keine Informationen aus dem Testset in das Training „durchsickern“ (Data Leakage) — etwa durch Normalisierung auf dem gesamten Datensatz vor dem Split.
Wie du dein Ergebnis in der Diskussion einordnest
Eine hohe Erkennungsrate allein ist noch keine überzeugende Diskussion. Ordne dein Ergebnis in mindestens drei Richtungen ein: Erstens im Vergleich zur gewählten Baseline — wie viel besser (oder schlechter) ist dein Modell wirklich? Zweitens im Vergleich zu publizierten Ergebnissen anderer Arbeiten auf demselben Datensatz, sofern verfügbar — das zeigt, ob dein Ergebnis im plausiblen Bereich liegt. Drittens hinsichtlich der Grenzen deines Vorgehens — etwa, ob dein Modell auf einem synthetisch erzeugten Benchmark trainiert wurde, der reale Netzwerke nur unvollständig abbildet. Welche Evaluationsform zu welcher Fragestellung passt, vergleicht unser Beitrag zu Evaluationsverfahren in der Informatik-Abschlussarbeit.
ChatGPT und KI-Tools bei der Umsetzung: was sie leisten und was nicht
KI-Tools wie ChatGPT können dir helfen, Modellcode zu strukturieren oder Fehlermeldungen zu verstehen — sie ersetzen aber weder die eigene Datenexploration noch die kritische Einordnung deiner Ergebnisse. Ein Modell, das dir ein Chatbot vorschlägt, ohne dass du die zugrunde liegenden Annahmen (z. B. Klassenungleichgewicht im Datensatz) verstehst, führt schnell zu Ergebnissen, die du in der Diskussion nicht überzeugend einordnen kannst. Wie du KI-generierten Code in deiner Informatik-Abschlussarbeit korrekt deklarierst, erklärt unser Beitrag Musst du KI-generierten Code in deiner Informatik-Abschlussarbeit deklarieren?.
Ethische und rechtliche Aspekte
Auch wenn du mit öffentlichen Benchmark-Datensätzen arbeitest, gehört ein kurzer Abschnitt zu Datenschutz und Forschungsethik in dein Methodikkapitel: Erkläre, ob der gewählte Datensatz personenbezogene Daten im Sinne der DSGVO enthalten kann und wie damit umgegangen wird. Willst du stattdessen reale Netzwerkdaten einer Organisation verwenden, brauchst du eine schriftliche Zusage der Organisation und musst klären, ob eine Ethikkommission oder die bzw. der Datenschutzbeauftragte einbezogen werden muss, bevor du mit der Datenerhebung beginnst. Ein Erkennungsmodell, das du im Rahmen deiner Bachelorarbeit trainierst, solltest du niemals gegen produktive, nicht dir gehörende Systeme testen — beschränke jeden praktischen Test auf die Benchmark-Daten oder eine eigens eingerichtete, isolierte Testumgebung.
Software-Stack für dein Experiment
Für viele Bachelorarbeiten in diesem Bereich reicht Python mit etablierten Bibliotheken: scikit-learn für klassische Machine-Learning-Modelle, TensorFlow oder PyTorch für neuronale Netze, sowie pandas und NumPy für die Datenvorverarbeitung. Jupyter Notebooks eignen sich gut für die explorative Analyse, für die finale, reproduzierbare Auswertung empfiehlt sich zusätzlich ein sauber strukturiertes Skript statt eines einzigen langen Notebooks. Einen breiteren Vergleich von Tools — von Versionskontrolle bis LaTeX — findest du in unserem Tool-Stack-Vergleich für die Informatik-Abschlussarbeit.
Zeitplan für dein ML-Experiment (illustrativ)
Der folgende Zeitplan ist ein frei konstruiertes Beispiel und ersetzt nicht die individuelle Absprache mit deiner Betreuung.
- Wochen 1–2: Literaturrecherche, Themeneingrenzung, Auswahl des Datensatzes
- Wochen 3–4: Datenexploration und Vorverarbeitung, erste Baseline-Modelle
- Wochen 5–7: Modelltraining, Hyperparameter-Tuning, Vergleich mehrerer Ansätze
- Wochen 8–9: Auswertung, Diskussion der Ergebnisse, Reproduzierbarkeits-Dokumentation
- Wochen 10–12: Verschriftlichung, Überarbeitung, Abgabe
Häufige Fehler bei diesem Thema
- Thema zu breit gelassen: „KI gegen Cyberangriffe“ statt eines konkreten Teilthemas mit konkretem Datensatz.
- Nur Accuracy als Metrik: Bei stark unausgeglichenen Datensätzen (wenige Angriffe, viele normale Verbindungen) ist Accuracy irreführend — Precision, Recall und F1-Score sind aussagekräftiger.
- Veraltete Datensätze unkritisch verwendet: Der ursprüngliche KDD-Cup-99-Datensatz gilt als problematisch — begründe die Wahl deines Datensatzes und diskutiere seine bekannten Schwächen.
- Fehlende Baseline: Ein KI-Modell ohne Vergleich zu einem einfachen Referenzverfahren lässt sich in der Diskussion schwer einordnen.
- KI-generierter Code ohne Verständnis übernommen: Code aus einem KI-Tool, dessen Funktionsweise du nicht erklären kannst, führt in der Verteidigung zu Problemen.
- Fehlende Reproduzierbarkeits-Dokumentation: Hyperparameter, Seeds und Vorverarbeitungsschritte werden nicht festgehalten und lassen sich später nicht mehr rekonstruieren.
Häufig gestellte Fragen zur KI-Bedrohungserkennung als Bachelorarbeitsthema
Brauche ich Vorkenntnisse in Machine Learning für dieses Thema?
Grundkenntnisse in Python und Statistik sind hilfreich; die konkreten ML-Konzepte (Klassifikation, Evaluationsmetriken) lassen sich parallel zur Bachelorarbeit erarbeiten, wenn du ausreichend Zeit für die Einarbeitung einplanst.
Muss ich einen eigenen Datensatz erheben?
Nein, für die meisten Bachelorarbeiten in diesem Bereich sind öffentliche Benchmark-Datensätze wie CICIDS2017 oder UNSW-NB15 der übliche und praktikable Weg.
Welches Modell sollte ich verwenden — klassisches ML oder Deep Learning?
Für eine Bachelorarbeit ist ein klassisches, gut interpretierbares Modell (z. B. Random Forest) oft die bessere Wahl als ein komplexes Deep-Learning-Modell, weil sich Ergebnisse leichter erklären und in der Verteidigung begründen lassen.
Wie gehe ich mit unausgeglichenen Datensätzen um?
Nutze Metriken wie Precision, Recall und F1-Score statt Accuracy, und ziehe Techniken wie Resampling oder klassen-gewichtete Modelle in Betracht — erkläre in der Methodik, warum du dich für einen bestimmten Umgang mit der Unausgeglichenheit entschieden hast.
Darf ich KI-Tools wie ChatGPT für den Code meiner Bachelorarbeit nutzen?
Das hängt von den Vorgaben deiner Hochschule ab — kläre die konkrete Deklarationspflicht mit deiner Betreuung. Grundsätzlich gilt: Du musst jeden verwendeten Code verstehen und in der Verteidigung erklären können, unabhängig davon, woher er stammt.
Wie eng sollte ich mein Thema letztlich eingrenzen?
So eng, dass sich die Forschungsfrage mit einem einzigen Datensatz, ein bis zwei vergleichbaren Modellen und einer klaren Evaluationsmetrik in der verfügbaren Bearbeitungszeit beantworten lässt — lieber ein enges Thema gründlich als ein breites Thema oberflächlich.
Wie wichtig ist Reproduzierbarkeit wirklich für die Note?
Das hängt vom Lehrstuhl ab — kläre die genauen Erwartungen mit deiner Betreuung, aber plane grundsätzlich Zeit für eine saubere Dokumentation aller Experimenteinstellungen ein.
Darf ich mein Erkennungsmodell an echten, produktiven Systemen testen?
Nein — teste dein Modell ausschließlich an Benchmark-Daten oder einer eigens eingerichteten, isolierten Testumgebung. Tests an produktiven, dir nicht gehörenden Systemen sind rechtlich riskant und für eine Bachelorarbeit nicht notwendig.
Wie unterscheidet sich dieses Thema von einer klassischen Software-Engineering-Bachelorarbeit?
Der Fokus liegt hier auf einem experimentellen Vorgehen mit Daten, Modelltraining und statistischer Auswertung statt auf der Entwicklung einer vollständigen Softwareanwendung — kläre mit deiner Betreuung, welcher Anteil an Implementierung gegenüber Auswertung für deine Bewertung erwartet wird.
Mit Tesify vom Thema zur fertigen Bachelorarbeit
Mehr als 9.000 Studierende haben mit Tesify bereits über 15.000 Kapitel ihrer Abschlussarbeiten erstellt — jedes davon zu 100 % von ihnen selbst geschrieben. Wenn dein Experiment steht und das Schreiben beginnt, starte deine Bachelorarbeit mit Tesify.