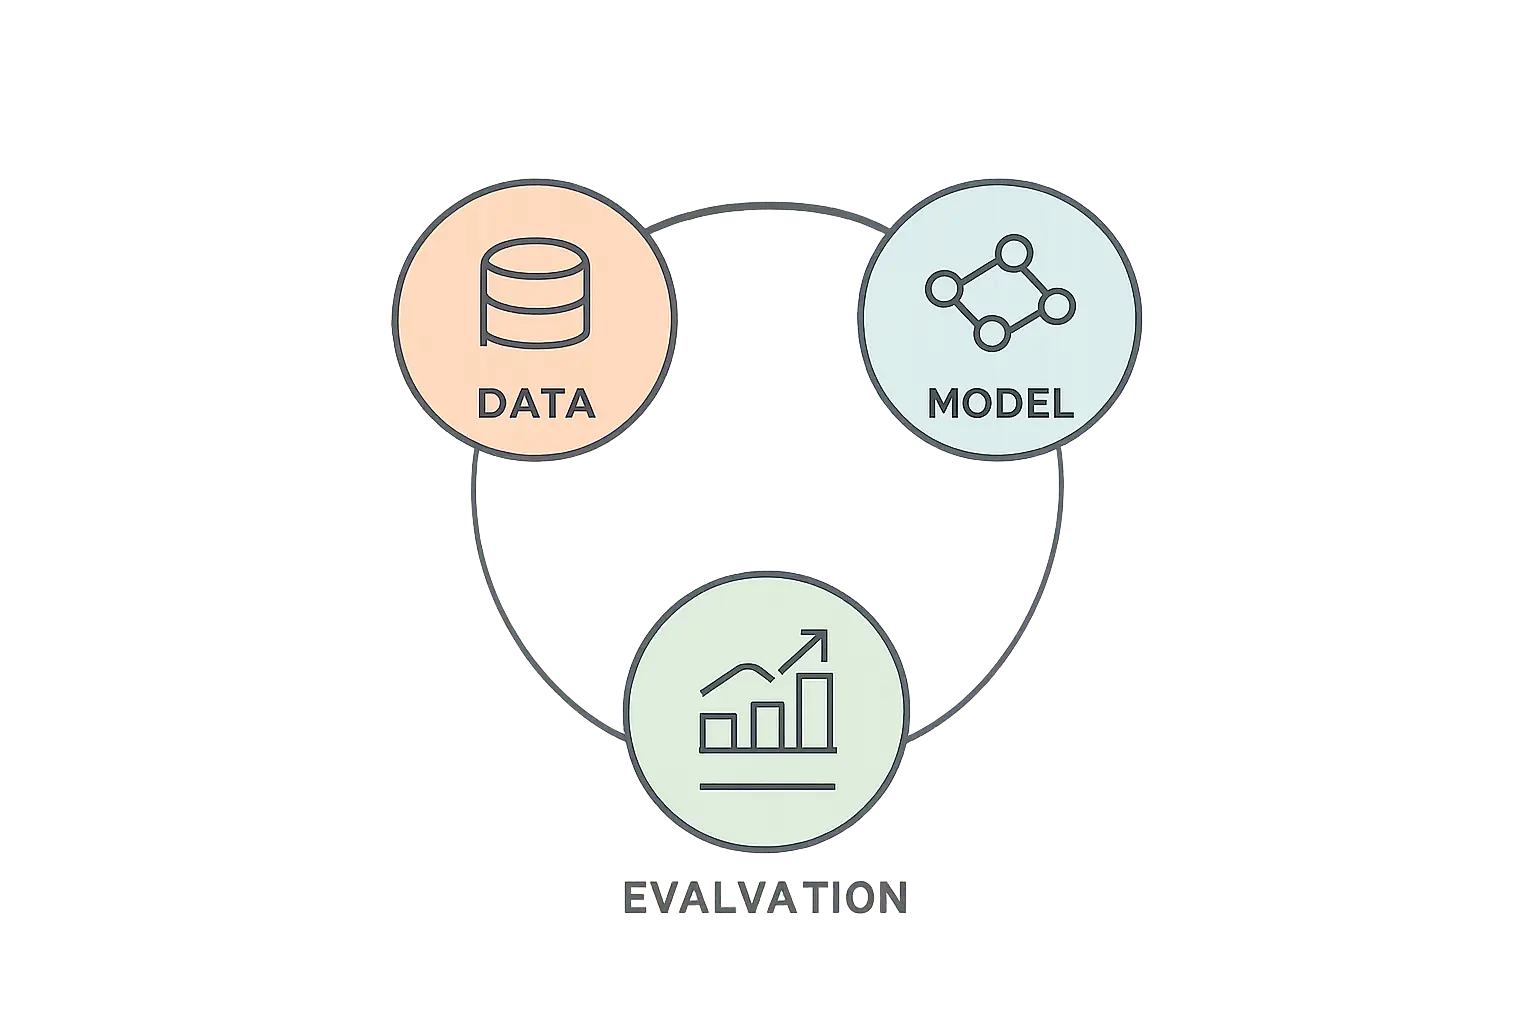
Eine Data-Science-Abschlussarbeit lässt sich nicht sauber in das klassische IMRaD-Schema aus Einleitung, Methodik, Ergebnissen und Diskussion pressen, weil der eigentliche Arbeitsprozess einer anderen Logik folgt: der eines Datenanalyse-Zyklus von der Datenerhebung bis zum trainierten und evaluierten Modell. Dieser Beitrag zeigt einen Kapitelaufbau, der sich an diesem Zyklus orientiert, Kapitel für Kapitel, mit Angaben dazu, was in jedes Kapitel gehört und was typischerweise fehlt.
Was ist die kurze Antwort?
- Der Aufbau orientiert sich am CRISP-DM-Zyklus, nicht am reinen IMRaD-Schema. Business Understanding, Data Understanding, Data Preparation, Modeling, Evaluation und Deployment bilden die inhaltliche Grundlage der Kapitelstruktur.
- Ein eigenes Datenkapitel ist Pflicht, kein Unterpunkt der Methodik. Herkunft, Qualität, Aufbereitung und explorative Analyse der Daten verdienen ein eigenständiges Kapitel, weil sie über die Aussagekraft aller späteren Ergebnisse entscheiden.
- Reproduzierbarkeit gehört strukturell in die Arbeit, nicht nur in den Anhang. Code-Repository, Umgebungsdokumentation und Zufalls-Seeds müssen so dokumentiert sein, dass ein Ergebnis nachvollzogen werden kann.
Warum passt das klassische IMRaD-Schema nicht direkt?
IMRaD wurde für Arbeiten entwickelt, die eine einzelne Hypothese mit einem einzelnen Experiment testen. Eine Data-Science-Arbeit durchläuft dagegen einen iterativen Prozess: Daten werden exploriert, bereinigt, mehrere Modellvarianten werden trainiert und verglichen, Fehleranalysen führen zurück zur Datenaufbereitung. Diese Iteration lässt sich in einem starren Einleitung-Methodik-Ergebnisse-Schema nur schwer abbilden. Der CRISP-DM-Zyklus, ein in der Industrie etabliertes Prozessmodell für Data-Mining-Projekte, bietet dafür eine passendere Gliederungslogik, weil er genau diese Phasen explizit benennt und in eine sinnvolle Reihenfolge bringt, ohne die Iteration zu verschweigen. Für die schriftliche Arbeit bedeutet das: Die Kapitelreihenfolge im fertigen Dokument darf linear wirken, auch wenn der tatsächliche Arbeitsprozess dahinter mehrfach zwischen Datenaufbereitung und Modellierung hin- und hergesprungen ist.
Kapitel 1: Einleitung und Problemstellung (Business Understanding)
Die Einleitung einer Data-Science-Arbeit muss zwei Dinge leisten, die oft vermischt werden: das fachliche oder geschäftliche Problem benennen, das gelöst werden soll, und die daraus abgeleitete Data-Science-Fragestellung präzisieren. „Kann Kundenabwanderung vorhergesagt werden?“ ist das fachliche Problem; „Mit welcher Genauigkeit lässt sich Kundenabwanderung anhand von Nutzungsdaten der letzten sechs Monate mit einem Gradient-Boosting-Modell vorhersagen, verglichen mit einer logistischen Regression als Baseline?“ ist die präzisierte Fragestellung. Die zweite Version ist die, mit der später tatsächlich gearbeitet wird.
Kapitel 2: Stand der Technik
Anders als in vielen anderen Fächern besteht der Forschungsstand in Data-Science-Arbeiten oft aus zwei Teilen: fachlicher Literatur zum Anwendungsproblem und methodischer Literatur zu den infrage kommenden Algorithmen. Beide sollten benannt und gegeneinander abgewogen werden, etwa warum ein Random Forest gegenüber einem neuronalen Netz für den gegebenen Datenumfang die plausiblere Wahl ist. Eine reine Auflistung von Algorithmusnamen ohne Bezug zur eigenen Datenlage überzeugt selten; die Wahl muss aus der Problemstellung und der Datenmenge begründet werden.
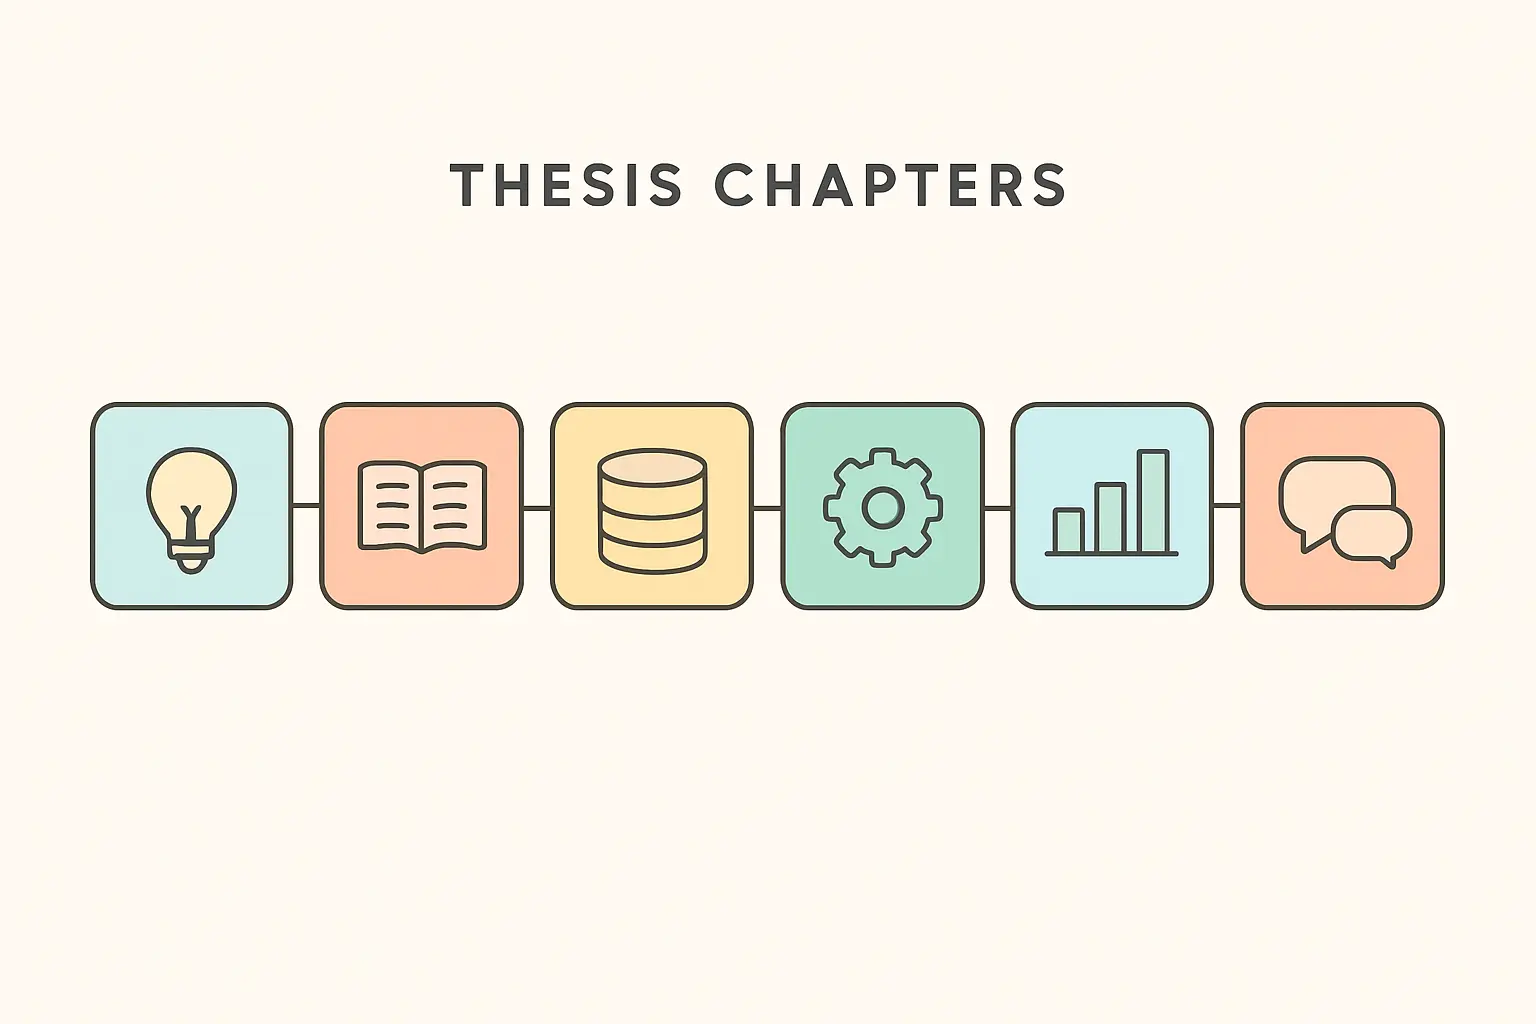
Kapitel 3: Daten (Data Understanding und Data Preparation)
Dieses Kapitel verdient in einer Data-Science-Arbeit besonders viel Raum, weil die Datenqualität die Obergrenze für jedes spätere Ergebnis setzt. Es sollte mindestens folgende Punkte enthalten: die Herkunft des Datensatzes und wie der Zugang zustande kam, die Größe und Struktur der Daten, eine explorative Datenanalyse mit Verteilungen und auffälligen Mustern, den Umgang mit fehlenden Werten und Ausreißern, und die Feature-Engineering-Schritte, die neue Variablen aus den Rohdaten ableiten. Jede Entscheidung in diesem Kapitel, etwa das Entfernen von Ausreißern oder eine bestimmte Imputationsmethode für fehlende Werte, sollte begründet werden, weil sie das Endergebnis direkt beeinflusst.
Ein Punkt wird in studentischen Arbeiten besonders häufig übersehen: Datenlecks (Data Leakage), bei denen Information aus dem Testdatensatz unbeabsichtigt in das Training einfließt, etwa durch eine Normalisierung, die vor der Aufteilung in Trainings- und Testdaten berechnet wurde. Ein eigener Absatz, der explizit bestätigt, dass die Aufteilung vor jeder datenabhängigen Transformation erfolgte, schützt vor diesem häufigen methodischen Fehler und zeigt der Betreuung, dass das Problem bewusst vermieden wurde.
Kapitel 4: Methodik und Modellierung
Hier werden die eingesetzten Algorithmen, die Aufteilung in Trainings-, Validierungs- und Testdaten, die Vorgehensweise beim Hyperparameter-Tuning und die verwendeten Bibliotheken mit Versionsnummern dokumentiert. Eine Tabelle mit allen getesteten Modellvarianten und ihren wichtigsten Hyperparametern erleichtert es, im Ergebniskapitel auf die einzelnen Varianten zurückzuverweisen. Auch die Wahl des Validierungsverfahrens, etwa k-fache Kreuzvalidierung oder eine zeitliche Aufteilung bei Zeitreihendaten, gehört hierher, mit einer kurzen Begründung, warum dieses Verfahren zur Datenstruktur passt.
Kapitel 5: Ergebnisse und Evaluation
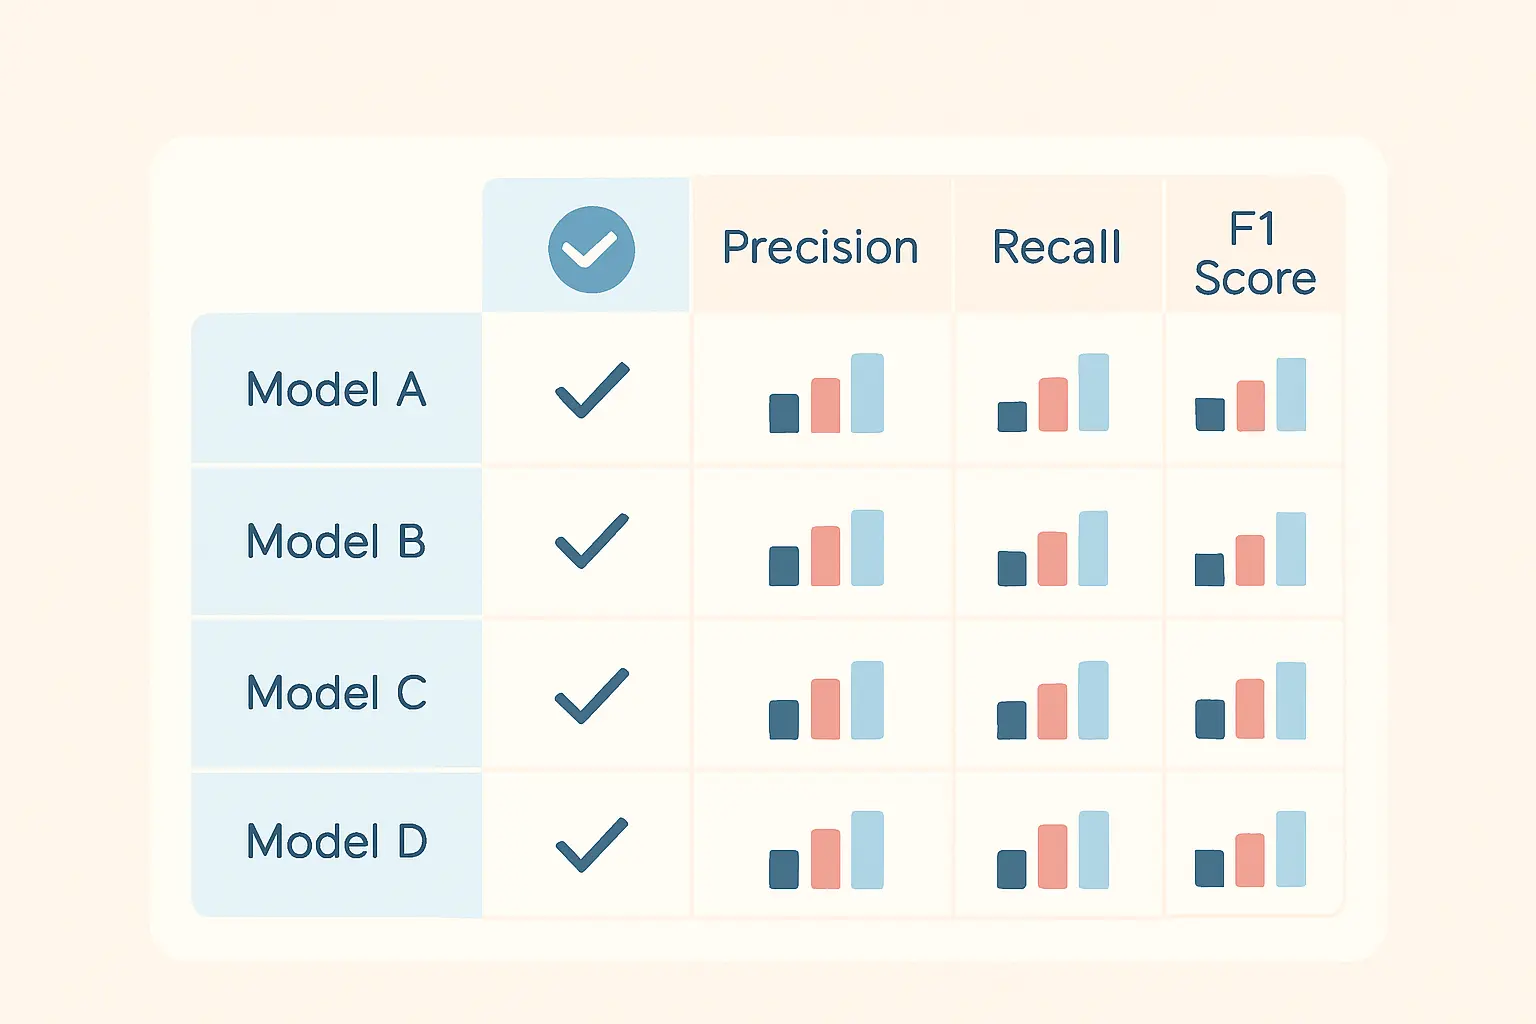
Die Ergebnisse werden mit den für das Problem passenden Metriken berichtet, nicht nur mit der Gesamtgenauigkeit. Bei unausgewogenen Klassifikationsproblemen, etwa seltener Kundenabwanderung, sind Precision, Recall und F1-Score aussagekräftiger als die reine Accuracy, die bei stark unausgewogenen Klassen irreführend hoch ausfallen kann. Eine Vergleichstabelle aller getesteten Modelle mit denselben Metriken auf denselben Testdaten macht den Vergleich nachvollziehbar. Ergänzend gehört eine kurze Fehleranalyse dazu: bei welchen Fällen das beste Modell besonders häufig falschliegt, und ob sich daraus ein Muster ablesen lässt.
Kapitel 6: Diskussion
Die Diskussion ordnet die Ergebnisse ein: Wie robust ist das beste Modell, welche Grenzen hat der verwendete Datensatz, etwa hinsichtlich Repräsentativität oder Aktualität, und welche ethischen oder Fairness-Aspekte sind relevant, wenn das Modell auf reale Personen angewendet würde. Gerade bei Modellen, die Entscheidungen über Menschen beeinflussen könnten, etwa Kreditvergabe oder Personalauswahl, sollte diskutiert werden, ob im Trainingsdatensatz systematische Verzerrungen gegenüber bestimmten Gruppen vorliegen könnten und wie sich das auf die Modellvorhersagen auswirkt.
Kapitel 7: Fazit und Ausblick
Das Fazit beantwortet die in der Einleitung präzisierte Fragestellung direkt und benennt, welche Weiterentwicklung sinnvoll wäre, etwa ein größerer oder aktuellerer Datensatz, ein Vergleich mit weiteren Algorithmusfamilien oder ein Testlauf mit echten Nutzerdaten unter kontrollierten Bedingungen.
Braucht meine Arbeit ein eigenes Deployment-Kapitel?
Nicht jede Abschlussarbeit muss ein trainiertes Modell tatsächlich produktiv einsetzen; für die meisten Bachelorarbeiten genügt ein kurzer Ausblick darauf, wie das Modell prinzipiell eingesetzt werden könnte, etwa als API-Endpunkt oder in eine bestehende Anwendung integriert. Wird tatsächlich ein Prototyp gebaut, etwa ein einfaches Dashboard oder eine Demo-Anwendung, verdient dieser Teil ein eigenes kurzes Kapitel, das den technischen Aufbau, die Grenzen des Prototyps und den Unterschied zu einer produktionsreifen Lösung beschreibt. Ein Prototyp ersetzt dabei nicht die wissenschaftliche Auswertung aus den vorherigen Kapiteln, sondern ergänzt sie um eine praktische Demonstration.
Der Anhang: Reproduzierbarkeit als eigener Bestandteil
Eine Data-Science-Arbeit ist erst dann vollständig nachvollziehbar, wenn ein Dritter das Ergebnis mit denselben Daten und demselben Code reproduzieren könnte. In den Anhang gehören deshalb ein Verweis auf das Code-Repository, eine Liste aller verwendeten Bibliotheken mit exakten Versionsnummern, die verwendeten Zufalls-Seeds für reproduzierbare Trainingsläufe und eine kurze Anleitung, wie die Umgebung eingerichtet wird. Viele Studiengänge verlangen mittlerweile explizit, dass der Code als separates Repository eingereicht wird; wo das nicht vorgeschrieben ist, erhöht es trotzdem die Glaubwürdigkeit der Arbeit erheblich.
Zur Reproduzierbarkeit gehört auch eine saubere Versionierung während der Erstellung der Arbeit, nicht erst am Ende: Jeder relevante Trainingslauf sollte mit Datum, verwendeten Daten, Hyperparametern und erzieltem Ergebnis protokolliert werden, etwa in einer einfachen Tabelle oder einem Experiment-Tracking-Werkzeug. Wer das erst nachträglich rekonstruieren will, verliert häufig den Überblick, welche Konfiguration tatsächlich zum berichteten Endergebnis geführt hat, besonders wenn im Laufe der Arbeit viele Varianten getestet wurden.
Ein Beispiel: die Kapitelübersicht für eine konkrete Arbeit
Für eine Bachelorarbeit zur Vorhersage von Maschinenausfällen anhand von Sensordaten könnte die Kapitelstruktur so aussehen: Kapitel 1 benennt das Problem ungeplanter Stillstandszeiten und die Fragestellung, ob ein Random-Forest-Modell Ausfälle 24 Stunden im Voraus zuverlässiger vorhersagt als ein Schwellenwertverfahren. Kapitel 2 ordnet bestehende Predictive-Maintenance-Ansätze ein. Kapitel 3 beschreibt den Sensordatensatz, die Behandlung fehlender Messwerte und die Konstruktion von Zeitfenster-Features. Kapitel 4 dokumentiert Trainings-Validierungs-Split nach Zeit statt Zufall, um Datenlecks bei Zeitreihen zu vermeiden, und das Hyperparameter-Tuning. Kapitel 5 vergleicht Random Forest und Schwellenwertverfahren anhand von Precision, Recall und F1-Score. Kapitel 6 diskutiert, dass der Datensatz nur eine Maschinentype abdeckt und die Übertragbarkeit auf andere Anlagentypen offen bleibt. Kapitel 7 fasst zusammen und schlägt eine Erweiterung auf mehrere Maschinentypen vor.
Welche Fehler sind im Aufbau von Data-Science-Arbeiten häufig?
- Das Datenkapitel wird zu kurz gehalten. Wenige Sätze zur Datenquelle ohne explorative Analyse lassen offen, ob die Datenqualität überhaupt für belastbare Ergebnisse ausreicht.
- Nur ein einziges Modell wird getestet. Ohne Vergleich zu mindestens einer einfacheren Baseline lässt sich nicht beurteilen, ob der Mehraufwand eines komplexeren Modells gerechtfertigt ist.
- Datenlecks werden nicht ausgeschlossen. Fehlt ein expliziter Hinweis, dass Trainings- und Testdaten vor jeder Transformation getrennt wurden, bleibt unklar, ob das berichtete Ergebnis überhaupt belastbar ist.
- Reproduzierbarkeit fehlt. Ohne Versionsnummern, Zufalls-Seeds und Code-Zugang lässt sich das Ergebnis nicht überprüfen, was in einem zunehmend auf Open Science ausgerichteten Fach negativ auffällt.
- Trainingsläufe werden nicht protokolliert. Wer im Laufe der Arbeit viele Modellvarianten testet, ohne sie systematisch zu dokumentieren, kann am Ende oft nicht mehr sicher sagen, welche Konfiguration zum berichteten Ergebnis geführt hat.
Häufige Fragen zum Aufbau der Data-Science-Abschlussarbeit
Muss ich mich strikt an CRISP-DM halten?
Nicht wortwörtlich, aber die grundlegende Phasenlogik von Datenverständnis über Aufbereitung und Modellierung bis zur Evaluation sollte in der Kapitelstruktur erkennbar bleiben, auch wenn die Kapitelüberschriften anders lauten.
Wie viele Modelle sollte ich mindestens vergleichen?
Mindestens zwei: das eigentlich interessierende Modell und eine einfachere Baseline, etwa eine logistische Regression oder ein Schwellenwertverfahren, um den Mehrwert der komplexeren Methode zu belegen.
Wie lang sollte das Datenkapitel im Verhältnis zur Gesamtarbeit sein?
Für die meisten Bachelorarbeiten sind fünfzehn bis fünfundzwanzig Prozent des Hauptteils angemessen, weil die Datenqualität die Grundlage für alle folgenden Kapitel bildet.
Gehört der komplette Code in die Arbeit selbst?
Nein, der vollständige Code gehört in ein separates Repository oder den Anhang; im Fließtext genügen kurze, illustrative Codeausschnitte für zentrale Schritte.
Wie gehe ich mit einem Datensatz um, der Verzerrungen gegenüber bestimmten Gruppen enthalten könnte?
Offen benennen, welche Verzerrungen möglich sind, und in der Diskussion einordnen, wie sich das auf die Interpretierbarkeit und mögliche reale Anwendung des Modells auswirkt, statt das Problem zu übergehen.
Reicht Accuracy als alleinige Metrik?
Bei ausgewogenen Klassen oft ausreichend, bei unausgewogenen Klassen fast nie; dort sind Precision, Recall und F1-Score aussagekräftiger und sollten ergänzend berichtet werden.
Wie protokolliere ich meine Trainingsläufe am besten?
Mit einer einfachen Tabelle aus Datum, verwendeten Daten, Hyperparametern und Ergebnis reicht es für die meisten Bachelorarbeiten; bei umfangreicheren Arbeiten lohnt sich ein dediziertes Experiment-Tracking-Werkzeug, das diese Protokollierung automatisiert.
Brauche ich einen echten Prototyp oder Dashboard-Demo für die Arbeit?
Nicht zwingend; ein kurzer konzeptioneller Ausblick auf den möglichen Einsatz reicht für die meisten Bachelorarbeiten. Ein tatsächlicher Prototyp ist ein Plus, ersetzt aber nicht die wissenschaftliche Auswertung der vorherigen Kapitel.
Unterscheidet sich der Aufbau zwischen Bachelor- und Masterarbeit in Data Science?
Der grundlegende Kapitelaufbau bleibt gleich; eine Masterarbeit verlangt aber typischerweise mehr getestete Modellvarianten, eine tiefere methodische Begründung im Stand der Technik und häufiger einen eigenen, wenn auch begrenzten Beitrag zur Methodik, nicht nur die Anwendung bestehender Verfahren.
Fazit
Der Aufbau einer Data-Science-Abschlussarbeit folgt sinnvoller dem Datenanalyse-Zyklus als dem starren IMRaD-Schema: Problemstellung, Stand der Technik, ein ausführliches Datenkapitel, Modellierung, Evaluation mit passenden Metriken, eine kritische Diskussion einschließlich möglicher Verzerrungen, und ein Anhang, der die Reproduzierbarkeit sicherstellt. Wer diese Struktur konsequent umsetzt, liefert eine Arbeit, die sowohl den fachlichen Anspruch des Data-Science-Prozesses als auch die wissenschaftlichen Anforderungen einer Abschlussarbeit erfüllt.