Der Beitrag zu Datenquellen für die Data-Science-Abschlussarbeit beantwortet, woher die Rohdaten für ein Modell kommen – Regierungsdatenportale, offene Repositorien, domänenspezifische Datensätze. Eine ganz andere Frage ist, woher die wissenschaftliche Literatur kommt, auf die sich der Theorie- und Forschungsstandsteil einer Data-Science-Arbeit stützt. Anders als in etablierten Fächern mit wenigen zentralen Fachzeitschriften ist die Publikationslandschaft in Machine Learning und Data Science ungewöhnlich fragmentiert: Ein Großteil der einflussreichsten Arbeiten erscheint zuerst als Preprint oder als Konferenzbeitrag, nicht in einer klassischen Zeitschrift. Dieser Beitrag ordnet die wichtigsten Quellen nach ihrer wissenschaftlichen Funktion und zeigt, worauf bei jeder Quellenart im Literaturverzeichnis zu achten ist.
arXiv: Der zentrale Preprint-Server für Machine Learning
arXiv (insbesondere die Kategorie cs.LG für Machine Learning sowie angrenzende Kategorien wie stat.ML) ist die zentrale Anlaufstelle für aktuelle Forschung in Data Science und Machine Learning. Die Plattform ist frei zugänglich, verlangt kein Abonnement und veröffentlicht Preprints – also Manuskripte, die von den Autorinnen und Autoren vor oder parallel zu einem regulären Peer-Review-Prozess hochgeladen werden. Für eine Abschlussarbeit ist deshalb wichtig: Ein arXiv-Preprint hat in der Regel noch kein vollständiges Peer-Review durchlaufen. Das macht ihn nicht per se unzitierfähig, verlangt aber eine eigene kritische Prüfung der Methodik, da die übliche externe Qualitätskontrolle einer Fachzeitschrift hier (noch) fehlt.
Journal of Machine Learning Research (JMLR): Peer-reviewte Open-Access-Publikation
Das Journal of Machine Learning Research ist eine seit 2000 bestehende, vollständig frei zugängliche und peer-reviewte Fachzeitschrift für Machine Learning. Anders als ein arXiv-Preprint hat ein JMLR-Artikel ein reguläres Begutachtungsverfahren durchlaufen, bevor er veröffentlicht wird. Für eine Abschlussarbeit ist JMLR deshalb eine besonders verlässliche Quelle, wenn eine bereits begutachtete, nicht nur vorläufige Fassung eines Ergebnisses zitiert werden soll. Laut eigener Startseite sind alle veröffentlichten Beiträge frei online verfügbar, und die elektronische Ausgabe erscheint unter der ISSN 1533-7928. Über die Kernzeitschrift hinaus verlinkt JMLR auf angegliederte Reihen wie PMLR (Konferenz-Proceedings), TMLR (Transactions) und DMLR (Data).
NeurIPS Proceedings: Top-Konferenzbeiträge statt Zeitschriftenartikel
In der Machine-Learning-Forschung sind Top-Konferenzen wie NeurIPS (Advances in Neural Information Processing Systems) oft bedeutender als klassische Zeitschriften – ein akzeptierter NeurIPS-Beitrag durchläuft ein strenges Begutachtungsverfahren und gilt in der Community oft als gleichwertig mit oder sogar wichtiger als eine Zeitschriftenpublikation. Die offizielle NeurIPS-Proceedings-Seite listet die akzeptierten Beiträge aller Jahrgänge seit 1987 frei zugänglich, inklusive eines eigenen „Datasets and Benchmarks“-Tracks seit 2021. Für eine Abschlussarbeit lohnt sich der Hinweis im Methodikkapitel, dass in diesem Fach Konferenzbeiträge und Zeitschriftenartikel gleichrangig als Quellen zitierfähig sind – ein Punkt, der in fachfremden Prüfungsordnungen mitunter nicht selbstverständlich vorausgesetzt wird.
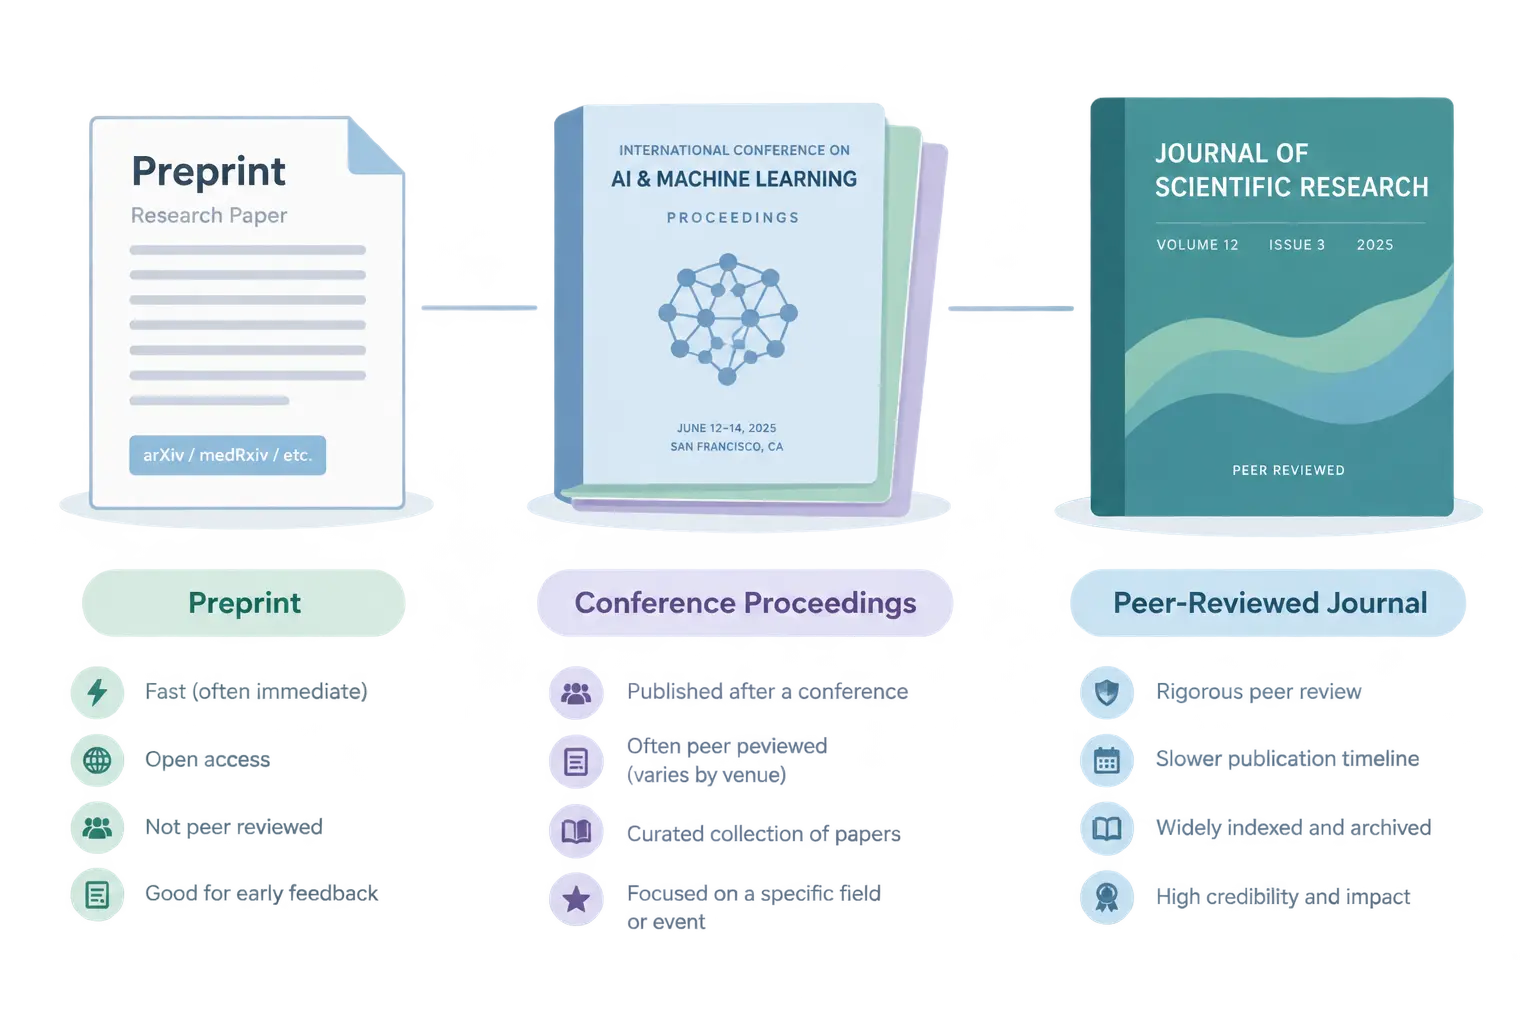
Diese Gleichrangigkeit hat eine praktische Konsequenz für die Literatursuche: Wer sich ausschließlich auf klassische Zeitschriftendatenbanken beschränkt, übersieht in Machine Learning systematisch einen großen Teil der relevanten und oft zitierten Forschung. Eine vollständige Literaturrecherche in diesem Fach muss deshalb explizit Konferenzproceedings einschließen, nicht nur Zeitschriften-Repositorien. Neben NeurIPS gehören auch ICML, ICLR und je nach Teilgebiet CVPR (Computer Vision) oder ACL (Sprachverarbeitung) zu den Konferenzen, deren Proceedings-Seiten in einer gründlichen Literaturrecherche berücksichtigt werden sollten.
Semantic Scholar und Google Scholar: KI-gestützte und breite Literatursuche
Semantic Scholar ist eine kostenlose, KI-gestützte Suchmaschine für wissenschaftliche Literatur, die nach eigenen Angaben über 214 Millionen Arbeiten aus allen Wissenschaftsbereichen durchsuchbar macht und zusätzliche Funktionen wie einen KI-gestützten „Semantic Reader“ sowie eine Entwickler-API bietet. Google Scholar deckt ein noch breiteres Spektrum ab – begutachtete Artikel, Preprints, Dissertationen und Bücher über praktisch alle Disziplinen hinweg – und ist ebenfalls kostenlos nutzbar, inklusive Zitationsmetriken und persönlichen Bibliotheksfunktionen. Für eine erste Literaturrecherche eignen sich beide Suchmaschinen komplementär: Semantic Scholar für eine stärker technisch-strukturierte Suche innerhalb der KI- und Informatikliteratur, Google Scholar für eine breitere, interdisziplinäre Recherche.
Vorsicht bei „Papers with Code“: Der Dienst leitet inzwischen um
Viele ältere Literaturlisten für Data-Science-Arbeiten nennen „Papers with Code“ als Anlaufstelle, um Paper mit zugehörigen Code-Implementierungen und Benchmark-Ergebnissen zu verknüpfen. Wer paperswithcode.com heute aufruft, wird automatisch auf die „Trending Papers“-Sektion von Hugging Face weitergeleitet. Es handelt sich um eine andere, wenn auch funktional verwandte Plattform – eine kuratierte, community-basierte Übersicht aktueller KI-Forschungsarbeiten mit Verlinkung zu GitHub-Repositorien und arXiv-Seiten, ebenfalls kostenlos nutzbar. Wer „Papers with Code“ in einer älteren Quelle zitiert findet, sollte vor der eigenen Verwendung prüfen, ob der Verweis noch aktuell ist, und im Zweifel die Hugging-Face-Nachfolgeseite referenzieren.
Ein durchgearbeitetes Beispiel: Literaturrecherche zu einem konkreten Thema
Angenommen, deine Bachelorarbeit behandelt Zeitreihenprognosen mit Transformer-Architekturen. Der erste Schritt ist eine Suche auf arXiv innerhalb der Kategorie cs.LG mit Suchbegriffen wie „time series forecasting transformer“, um die aktuellsten, noch nicht zwingend begutachteten Ansätze zu identifizieren. Parallel dazu liefert eine Suche in den NeurIPS- oder ICML-Proceedings der letzten drei bis vier Jahre die begutachteten, community-anerkannten Referenzarchitekturen, an denen sich neuere Arbeiten typischerweise messen. Google Scholar eignet sich anschließend, um die Zitationshäufigkeit zentraler Arbeiten zu prüfen und darüber die tatsächlich einflussreichen von den weniger rezipierten Beiträgen zu unterscheiden. Semantic Scholar ergänzt das um die „Citations“- und „References“-Netzwerkansicht, mit der sich verwandte Arbeiten auffinden lassen, die über reine Schlagwortsuche leicht übersehen werden. Aus diesen vier Quellen ergibt sich ein belastbares Literaturgerüst: aktuelle Preprints für den Stand der Technik, begutachtete Konferenzbeiträge als methodisches Fundament, und Zitationsanalysen zur Einordnung der Relevanz.
Ein zweites Beispiel aus dem Bereich der Computer Vision zeigt dieselbe Logik: Bei einer Arbeit zu Bildsegmentierung mit Diffusionsmodellen liefert JMLR die begutachteten Grundlagenartikel zu Diffusionsmodellen selbst, während aktuelle Anwendungen auf Segmentierungsaufgaben meist zuerst auf arXiv und in den Proceedings von CVPR oder ICCV erscheinen. Die Kombination aus etablierter Grundlagenliteratur und aktueller Anwendungsforschung ist in praktisch jedem Data-Science-Teilgebiet dieselbe Struktur.
Wie organisiere ich die gefundene Literatur für die eigene Arbeit?
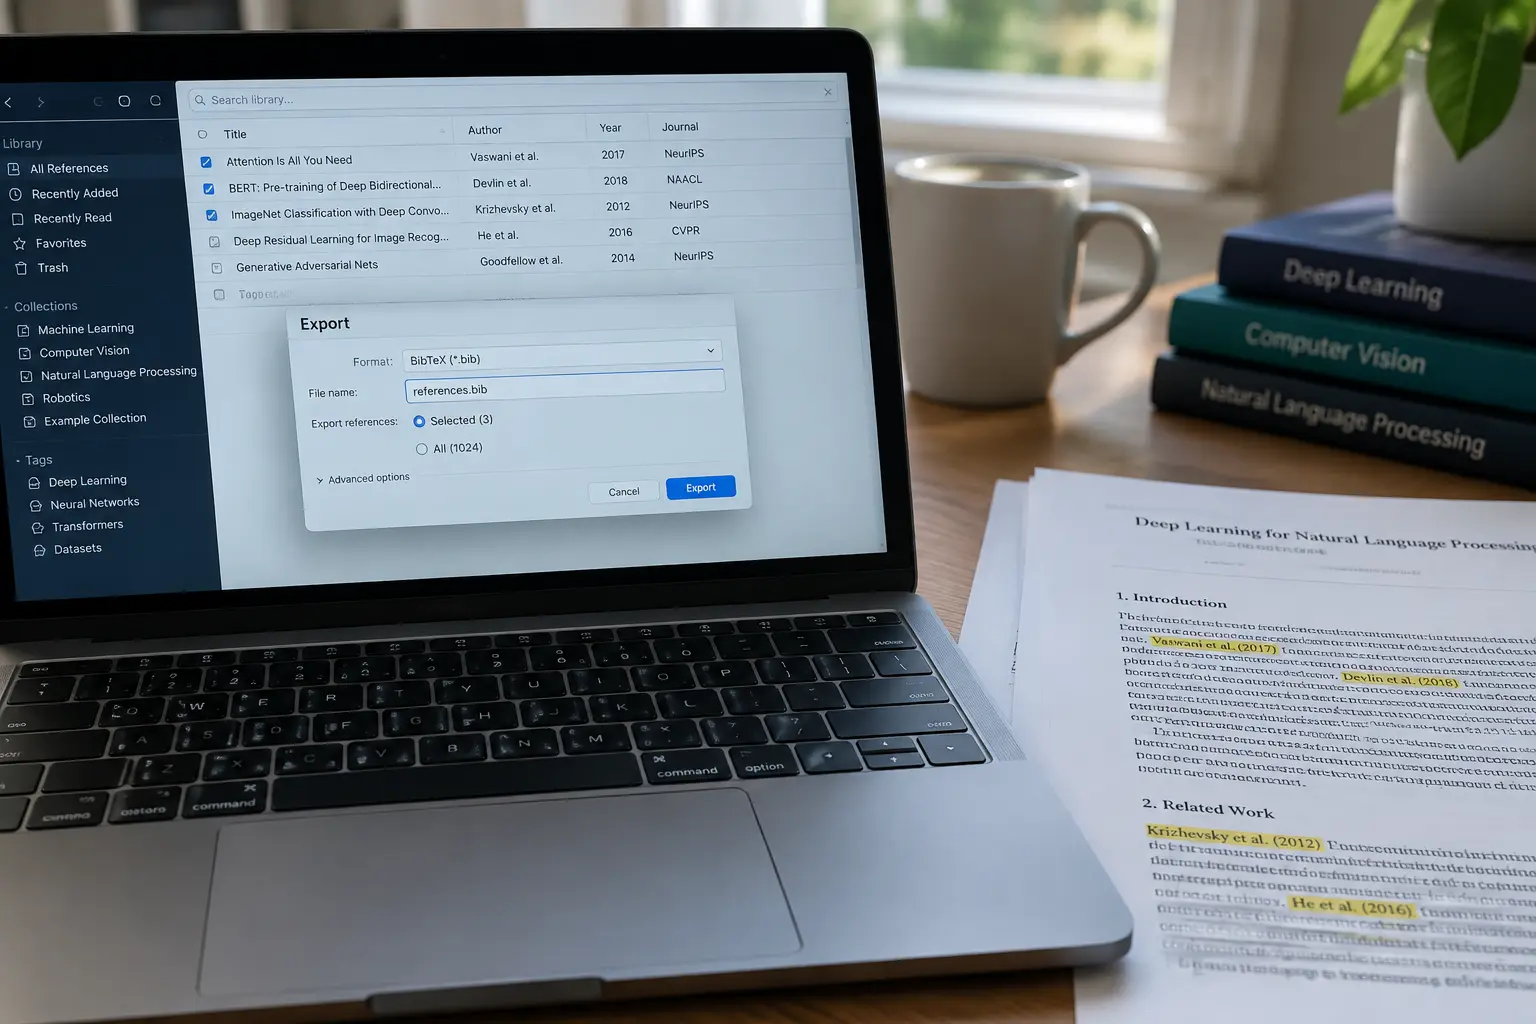
Fast alle genannten Quellen bieten einen direkten BibTeX-Export an – arXiv, NeurIPS-Proceedings und Google Scholar erzeugen auf Knopfdruck einen fertigen Zitationseintrag, der sich in Literaturverwaltungsprogramme importieren lässt. Das erspart nicht nur Tipparbeit, sondern reduziert auch Übertragungsfehler bei Autorennamen, Jahreszahlen und Titeln, die beim manuellen Abschreiben leicht entstehen. Wichtig ist trotzdem eine stichprobenartige Kontrolle der importierten Einträge, da automatisch generierte BibTeX-Einträge insbesondere bei Preprints gelegentlich veraltete Versionsangaben oder unvollständige Autorenlisten enthalten, wenn ein Paper nach dem ursprünglichen Import aktualisiert wurde.
Wie zitiere ich Preprints, Konferenzbeiträge und Zeitschriftenartikel korrekt unterschiedlich?
Im Literaturverzeichnis sollte der Publikationsstatus einer Quelle immer erkennbar bleiben: Ein arXiv-Preprint wird mit dem Zusatz „Preprint“ oder der arXiv-Kennung zitiert, ein Konferenzbeitrag mit Konferenzname und Jahr, ein Zeitschriftenartikel mit Zeitschriftentitel, Jahrgang und Seitenzahlen. In numerischen Zitierstilen wie Vancouver oder IEEE, die in technischen Fächern verbreitet sind, werden alle drei Quellentypen einheitlich fortlaufend nummeriert, aber im Vollbeleg weiterhin nach Publikationstyp unterschieden. Die Unterschiede zwischen diesen nummerierten Zitiersystemen und den autorbasierten Stilen wie APA erklärt der Beitrag zur Vancouver- und IEEE-Zitierweise.
Wie ordne ich Literaturquellen in den Aufbau meiner Data-Science-Arbeit ein?
Der Beitrag zum Aufbau der Data-Science-Abschlussarbeit erklärt, warum sich die Gliederung eher am CRISP-DM-Zyklus als am klassischen IMRaD-Schema orientiert – ein eigenes Datenkapitel und ein Reproduzierbarkeits-Abschnitt gehören dort zum Standardaufbau. Die hier vorgestellten Literaturquellen liefern typischerweise den Forschungsstand für den Theorieteil sowie die Vergleichsbasis für den Diskussionsteil, in dem die eigenen Ergebnisse gegen publizierte Benchmarks eingeordnet werden. Für die methodische Ausarbeitung selbst, insbesondere den leckagefreien Datensplit und die Wahl der Baseline, ist der Beitrag zum Methodenkapitel der Data-Science-Abschlussarbeit die passende Ergänzung. Wer noch auf der Suche nach einem passenden Thema ist, findet im Beitrag zu 30 Themen für die Data-Science-Abschlussarbeit Vorschläge, bei denen sich Forschungsfrage und Literaturlage bereits gegenseitig absichern.
Wie beurteile ich die Qualität einer gefundenen Quelle, wenn kein klassisches Peer-Review vorliegt?
Bei Preprints und selbst bei manchen Konferenzbeiträgen lohnt sich eine eigene kleine Qualitätsprüfung, bevor die Quelle als tragende Referenz in den theoretischen Rahmen aufgenommen wird. Sinnvolle Prüfkriterien sind: Wird der Code zur Reproduktion der Ergebnisse mitveröffentlicht? Wird das Paper von anderen, bereits etablierten Arbeiten zitiert (über Google Scholar oder Semantic Scholar prüfbar)? Stammen die Autorinnen und Autoren von einer Institution mit nachvollziehbarer Forschungshistorie in dem Bereich? Keines dieser Kriterien ersetzt ein formales Peer-Review, aber gemeinsam liefern sie einen belastbaren Anhaltspunkt dafür, ob ein noch nicht begutachtetes Ergebnis vorsichtig oder mit größerem Vertrauen zitiert werden kann. Für eine Bachelorarbeit reicht es meist, diese Prüfung für die drei bis fünf zentralen, tragenden Quellen der Arbeit durchzuführen, statt jede einzelne der oft zwanzig bis vierzig zitierten Arbeiten im Detail zu untersuchen.
Typische Fehler bei der Literaturrecherche in Data Science
- Ausschließlich Preprints zitieren, ohne den Status zu kennzeichnen. Ein Theorieteil, der zu 80 % aus unveröffentlichten arXiv-Preprints besteht, ohne dies transparent zu machen, wirkt für Gutachtende unausgewogen.
- Konferenzbeiträge als „weniger wertvoll“ als Zeitschriftenartikel einordnen. In Machine Learning gilt oft das Gegenteil – ein NeurIPS- oder ICML-Beitrag zählt häufig mehr als ein Artikel in einer weniger renommierten Zeitschrift.
- Veraltete Toolnamen unkritisch übernehmen. Wie das Beispiel „Papers with Code“ zeigt, verändern sich Namen und URLs von Recherchetools; ein Verweis sollte vor der Übernahme in die eigene Arbeit auf Aktualität geprüft werden.
- Nur eine einzige Suchmaschine nutzen. Semantic Scholar und Google Scholar liefern erfahrungsgemäß unterschiedliche Trefferlisten für dieselbe Suchanfrage, sodass sich eine Recherche über beide Systeme lohnt.
- BibTeX-Exporte ungeprüft übernehmen. Automatisch generierte Zitationseinträge sollten stichprobenartig gegen die Originalquelle geprüft werden, besonders bei Preprints mit mehreren Versionen.
Häufige Fragen zu Literaturquellen für die Data-Science-Abschlussarbeit
Darf ich arXiv-Preprints in einer Bachelorarbeit zitieren?
Ja, das ist in Data Science und Machine Learning üblich und akzeptiert, solange der Preprint-Status im Literaturverzeichnis kenntlich gemacht wird und die Methodik eigenständig kritisch geprüft wird.
Ist JMLR eine seriöse Zeitschrift, obwohl sie kostenlos zugänglich ist?
Ja. JMLR ist eine seit 2000 bestehende, peer-reviewte Open-Access-Zeitschrift und eine etablierte Publikationsreihe im Bereich Machine Learning – kostenloser Zugang und wissenschaftliche Qualität schließen sich hier nicht aus.
Sind Konferenzbeiträge wie NeurIPS-Paper in einer Abschlussarbeit zitierfähig?
Ja, und in Machine Learning sind sie oft sogar die wichtigste Quellenart. Ein akzeptierter Beitrag bei einer Top-Konferenz hat ein strenges Begutachtungsverfahren durchlaufen.
Was ist der Unterschied zwischen Semantic Scholar und Google Scholar?
Semantic Scholar fokussiert stärker auf KI-gestützte Suche innerhalb der wissenschaftlichen Literatur mit Zusatzfunktionen wie einem intelligenten Reader, während Google Scholar ein breiteres, interdisziplinäres Spektrum an Quellentypen abdeckt.
Existiert „Papers with Code“ noch?
Die ursprüngliche URL leitet inzwischen auf die „Trending Papers“-Sektion von Hugging Face weiter, eine funktional verwandte, aber andere Plattform. Ältere Verweise auf „Papers with Code“ sollten vor der Übernahme geprüft werden.
Muss ich Preprint und Zeitschriftenartikel im Literaturverzeichnis unterschiedlich kennzeichnen?
Ja. Der Publikationsstatus sollte im Vollbeleg erkennbar sein, etwa durch den Zusatz „Preprint“ oder die arXiv-Kennung bei unveröffentlichten Manuskripten.
Reicht eine einzige Suchmaschine für die Literaturrecherche aus?
Nicht unbedingt. Verschiedene Suchmaschinen liefern für dieselbe Anfrage unterschiedliche Trefferlisten, weshalb sich eine Recherche über mehrere Systeme hinweg empfiehlt.
Kann ich mich beim Zitieren blind auf automatisch generierte BibTeX-Einträge verlassen?
Nein, eine stichprobenartige Prüfung gegen die Originalquelle ist ratsam, da automatisch generierte Einträge insbesondere bei mehrfach überarbeiteten Preprints veraltete Angaben enthalten können.
Muss meine Literaturliste ausschließlich englischsprachige Quellen enthalten?
Nicht zwingend, aber in der Praxis überwiegen englischsprachige Quellen in Machine Learning und Data Science deutlich, da die Forschungscommunity international und überwiegend englischsprachig publiziert. Deutschsprachige Sekundärliteratur kann ergänzend für den DACH-Kontext sinnvoll sein, etwa bei Anwendungsfragen mit regionalem Bezug.
Mit Tesify die Literaturquellen strukturiert einordnen
Mit Tesify planst und strukturierst du deinen Forschungsstand – von der Unterscheidung zwischen Preprint, Konferenzbeitrag und Zeitschriftenartikel bis zur Gliederung des Literaturteils –, und jeder Satz bleibt zu 100 % von dir geschrieben. Starte jetzt mit Tesify und ordne deine Quellen Schritt für Schritt in die Kapitelstruktur ein. Über 9.000 Studierende und mehr als 15.000 Kapitel stehen hinter Tesify.